導入と問題の所在
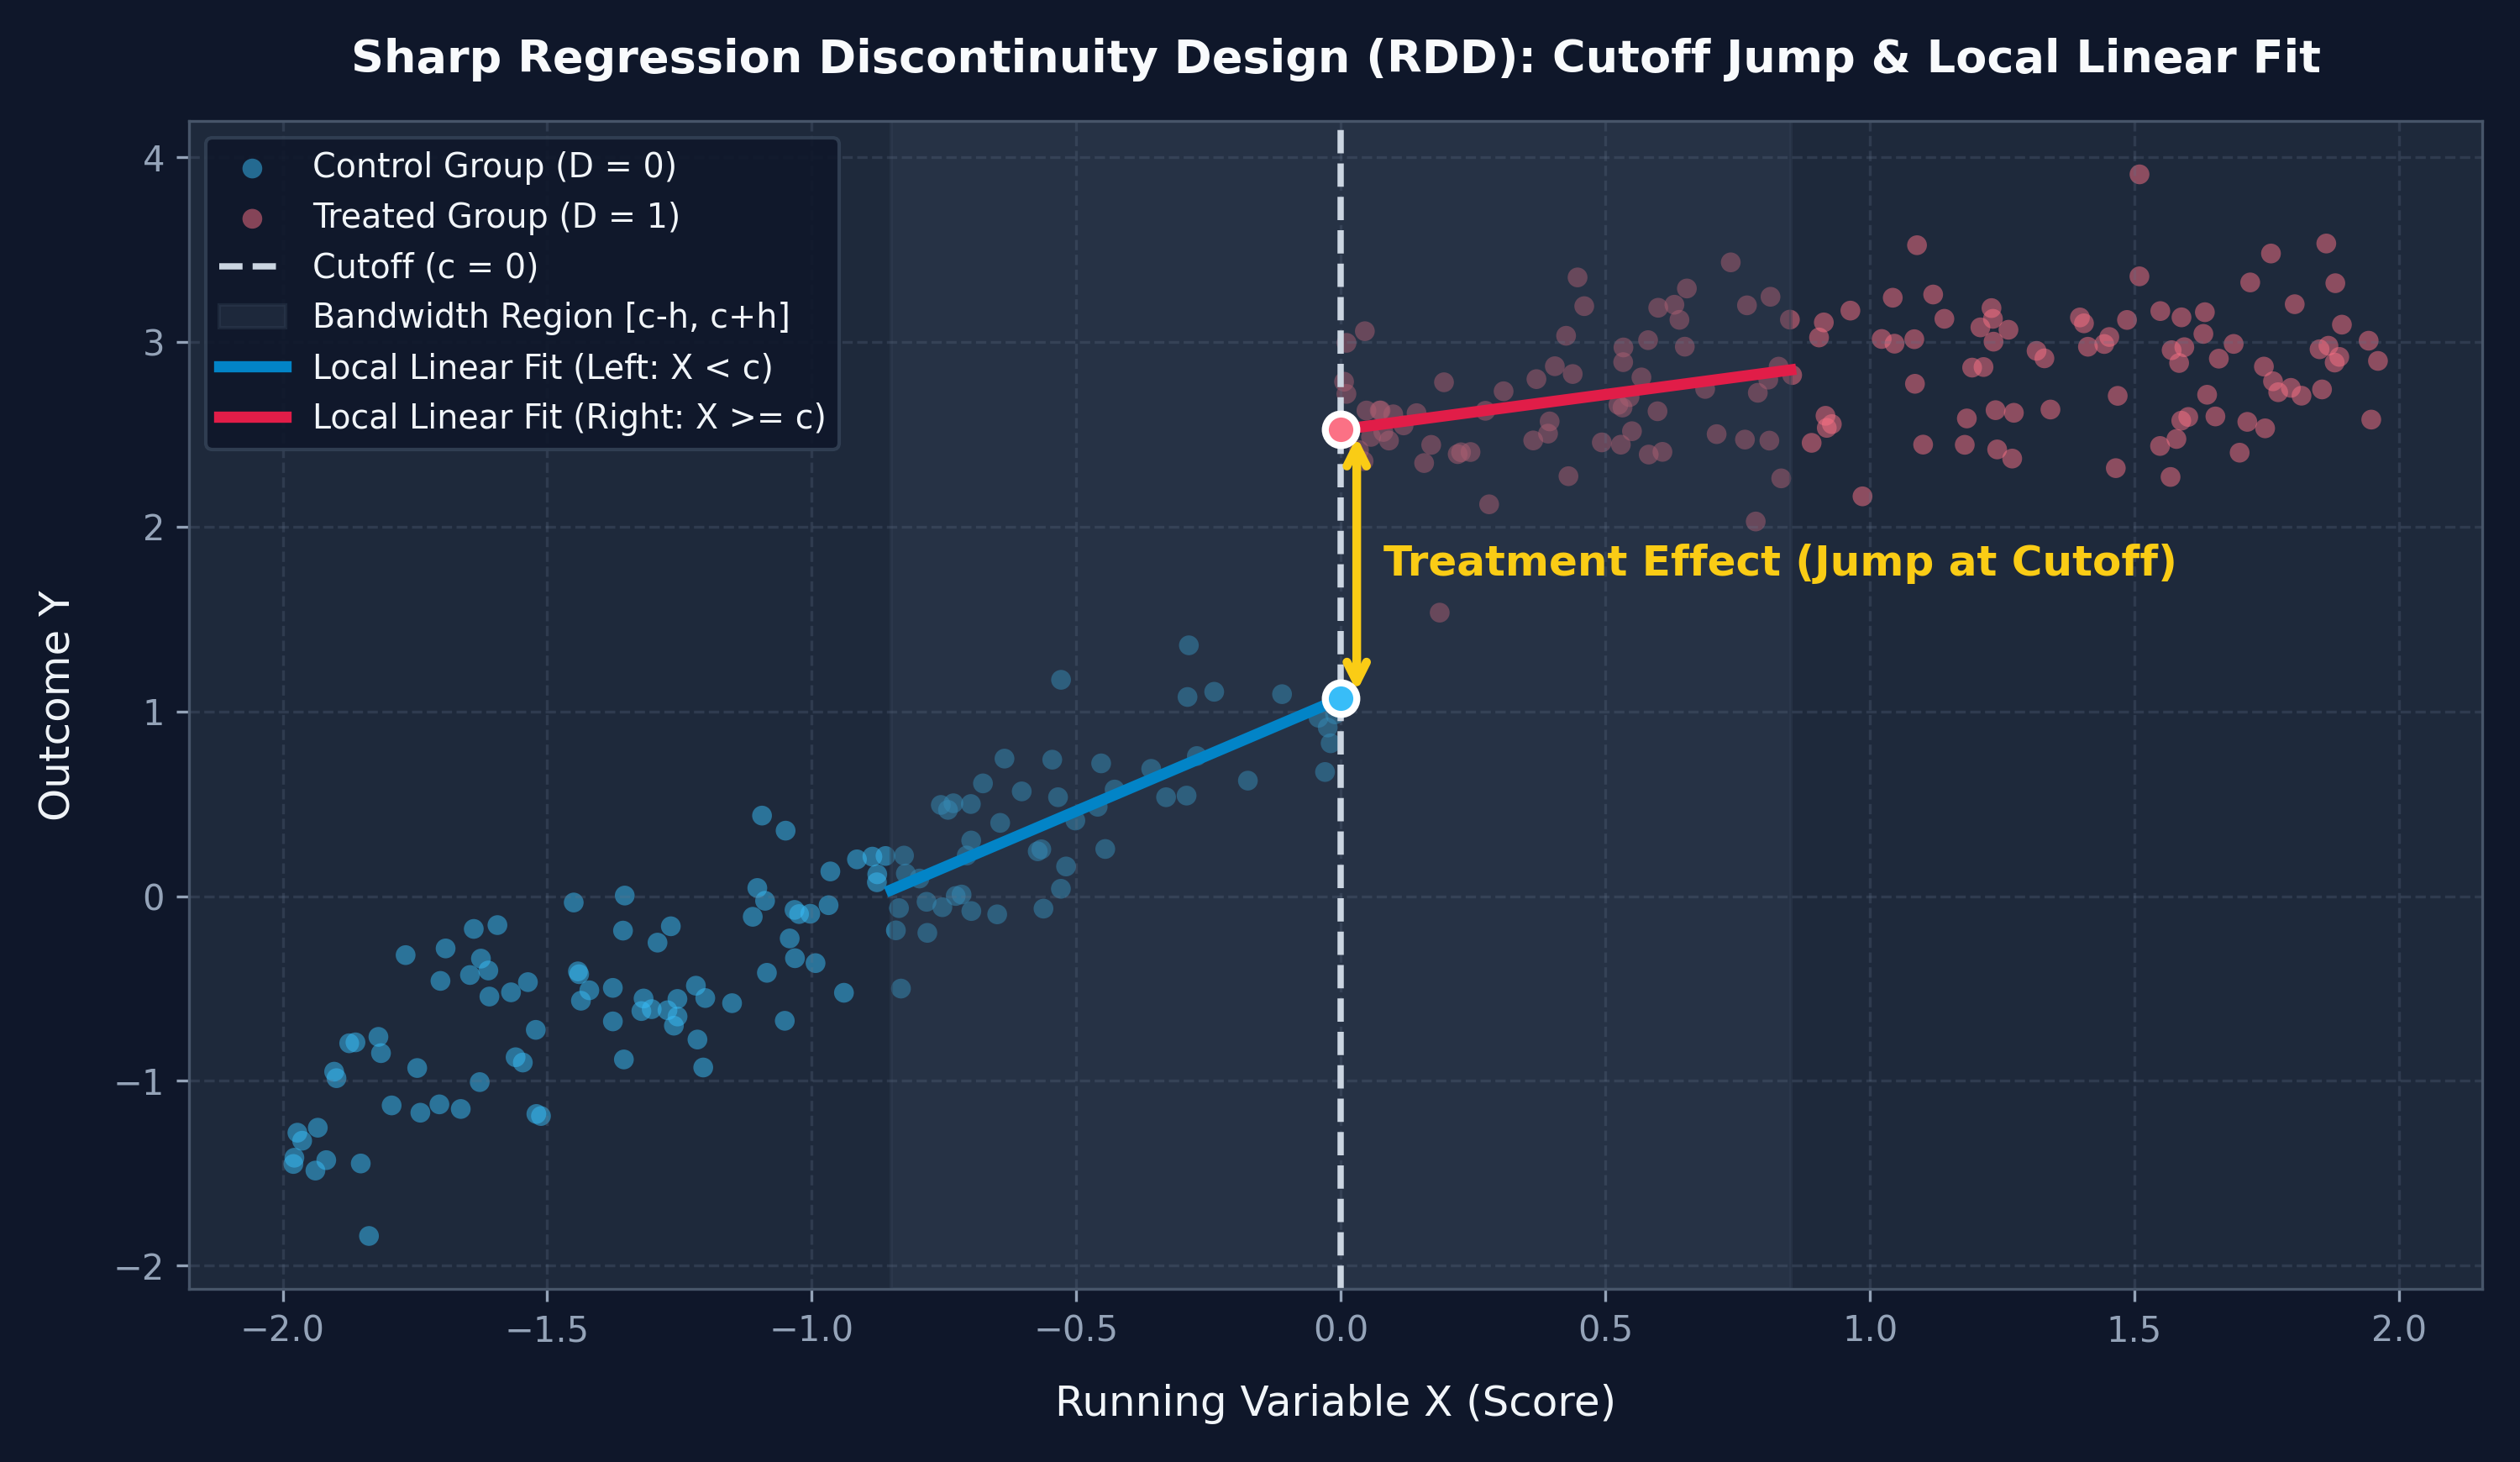
因果推論の現場において、ランダム化比較試験(RCT)が倫理的・実務的制約から実施できない状況で、最も強力かつ信頼性の高い準実験手法の1つが回帰不連続デザイン(Regression Discontinuity Design; RDD) です。
しかし、ノンパラメトリック回帰の文脈で RDD の推定理論を本格的に学ぼうとすると、初学者はもちろん実務経験者であっても、教科書の記述に対して以下のような強い疑問やモヤモヤを抱くことになります。
「なぜカットオフ境界で通常のカーネル回帰ではなく局所多項式(特に局所線形:LL)回帰を使うのか?」 (境界バイアスの相殺メカニズムの数学的必然性はどこにあるのか?)「漸近分散とバイアスのトレードオフから導かれる最適バンド幅 h h h (n h 5 → 0 nh^5 \to 0 n h 5 → 0 W ( h , b ) W(h, b) W ( h , b ) 「Kolesár and Rothe (2018) が提唱する『偽りのない(Honest)信頼区間』とは何であり、なぜ通常の漸近信頼区間はデータ生成過程に関して一様(Uniform)に成り立たないのか?」
計量経済学と機械学習の融合を体系的に解説した名著・末石直也 著『データ駆動型回帰分析――計量経済学と機械学習の融合』(日本評論社、2021年)第3章「回帰不連続デザイン」(p.64〜p.70)においても、これらの核心的な数理ステップは高度な前提知識として凝縮されており、初読時には行間を埋めるのに苦労する難所となっています。
本記事では、このテキストで省略されている局所線形回帰推定量(LL推定量)の境界バイアス導出 、バイアス修正に伴う分散の拡大構造 、そして現代的なノンパラメトリック推論の金字塔である一様に妥当なオネスト信頼区間(Honest Confidence Interval)の数理的行間 を徹底的に解きほぐしていきます。
背景にある前提・設定
まずは、提示されたテキストの記号体系と基本設定を厳密に整理しましょう。
各個体 i = 1 , … , n i = 1, \dots, n i = 1 , … , n
X i ∈ R X_i \in \mathbb{R} X i ∈ R Y i ∈ R Y_i \in \mathbb{R} Y i ∈ R D i ∈ { 0 , 1 } D_i \in \{0, 1\} D i ∈ { 0 , 1 }
処置の割り当ては、既知のカットオフ値 c c c
D i = 1 { X i ≥ c } D_i = \mathbf{1}\{X_i \ge c\} D i = 1 { X i ≥ c } 個体 i i i ( Y i ( 0 ) , Y i ( 1 ) ) (Y_i(0), Y_i(1)) ( Y i ( 0 ) , Y i ( 1 ))
Y i = ( 1 − D i ) Y i ( 0 ) + D i Y i ( 1 ) Y_i = (1 - D_i)Y_i(0) + D_i Y_i(1) Y i = ( 1 − D i ) Y i ( 0 ) + D i Y i ( 1 ) 関心の対象は、カットオフ c c c
τ r d d ≡ E [ Y i ( 1 ) − Y i ( 0 ) ∣ X i = c ] \tau_{rdd} \equiv \mathbb{E}[Y_i(1) - Y_i(0) \mid X_i = c] τ r dd ≡ E [ Y i ( 1 ) − Y i ( 0 ) ∣ X i = c ] 識別の鍵:オーバーラップの欠如と極限による連続性
一般的な傾向スコアやマッチング法ではオーバーラップ(正値性)仮定 (0 < P ( D i = 1 ∣ X i = x ) < 1 0 < P(D_i = 1 \mid X_i = x) < 1 0 < P ( D i = 1 ∣ X i = x ) < 1 x ≥ c x \ge c x ≥ c 1 1 1 x < c x < c x < c 0 0 0 完全に崩壊 しています。
これを補うのが「潜在的結果変数の条件付き期待値 μ 1 ( x ) ≡ E [ Y i ( 1 ) ∣ X i = x ] \mu_1(x) \equiv \mathbb{E}[Y_i(1) \mid X_i = x] μ 1 ( x ) ≡ E [ Y i ( 1 ) ∣ X i = x ] μ 0 ( x ) ≡ E [ Y i ( 0 ) ∣ X i = x ] \mu_0(x) \equiv \mathbb{E}[Y_i(0) \mid X_i = x] μ 0 ( x ) ≡ E [ Y i ( 0 ) ∣ X i = x ] x = c x = c x = c
μ + ≡ lim x ↓ c E [ Y i ∣ X i = x ] = lim x ↓ c E [ Y i ( 1 ) ∣ X i = x ] = E [ Y i ( 1 ) ∣ X i = c ] μ − ≡ lim x ↑ c E [ Y i ∣ X i = x ] = lim x ↑ c E [ Y i ( 0 ) ∣ X i = x ] = E [ Y i ( 0 ) ∣ X i = c ] \begin{aligned}
\mu_+ &\equiv \lim_{x \downarrow c} \mathbb{E}[Y_i \mid X_i = x] = \lim_{x \downarrow c} \mathbb{E}[Y_i(1) \mid X_i = x] = \mathbb{E}[Y_i(1) \mid X_i = c] \\
\mu_- &\equiv \lim_{x \uparrow c} \mathbb{E}[Y_i \mid X_i = x] = \lim_{x \uparrow c} \mathbb{E}[Y_i(0) \mid X_i = x] = \mathbb{E}[Y_i(0) \mid X_i = c]
\end{aligned}
μ + μ − ≡ x ↓ c lim E [ Y i ∣ X i = x ] = x ↓ c lim E [ Y i ( 1 ) ∣ X i = x ] = E [ Y i ( 1 ) ∣ X i = c ] ≡ x ↑ c lim E [ Y i ∣ X i = x ] = x ↑ c lim E [ Y i ( 0 ) ∣ X i = x ] = E [ Y i ( 0 ) ∣ X i = c ] したがって、
τ r d d = μ + − μ −
\tau_{rdd} = \mu_+ - \mu_- τ r dd = μ + − μ − となり、問題は「右側極限値 μ + \mu_+ μ + μ − \mu_- μ −
核心の導出 & 概念のかみ砕き解説
ここからが本題です。教科書で「LL推定量の境界点での推定」「n h 5 → 0 nh^5 \to 0 n h 5 → 0
1. 境界バイアスの数理:なぜ Nadaraya-Watson ではなく局所線形(LL)なのか?
テキストの式 (3.16) では、カットオフ c c c
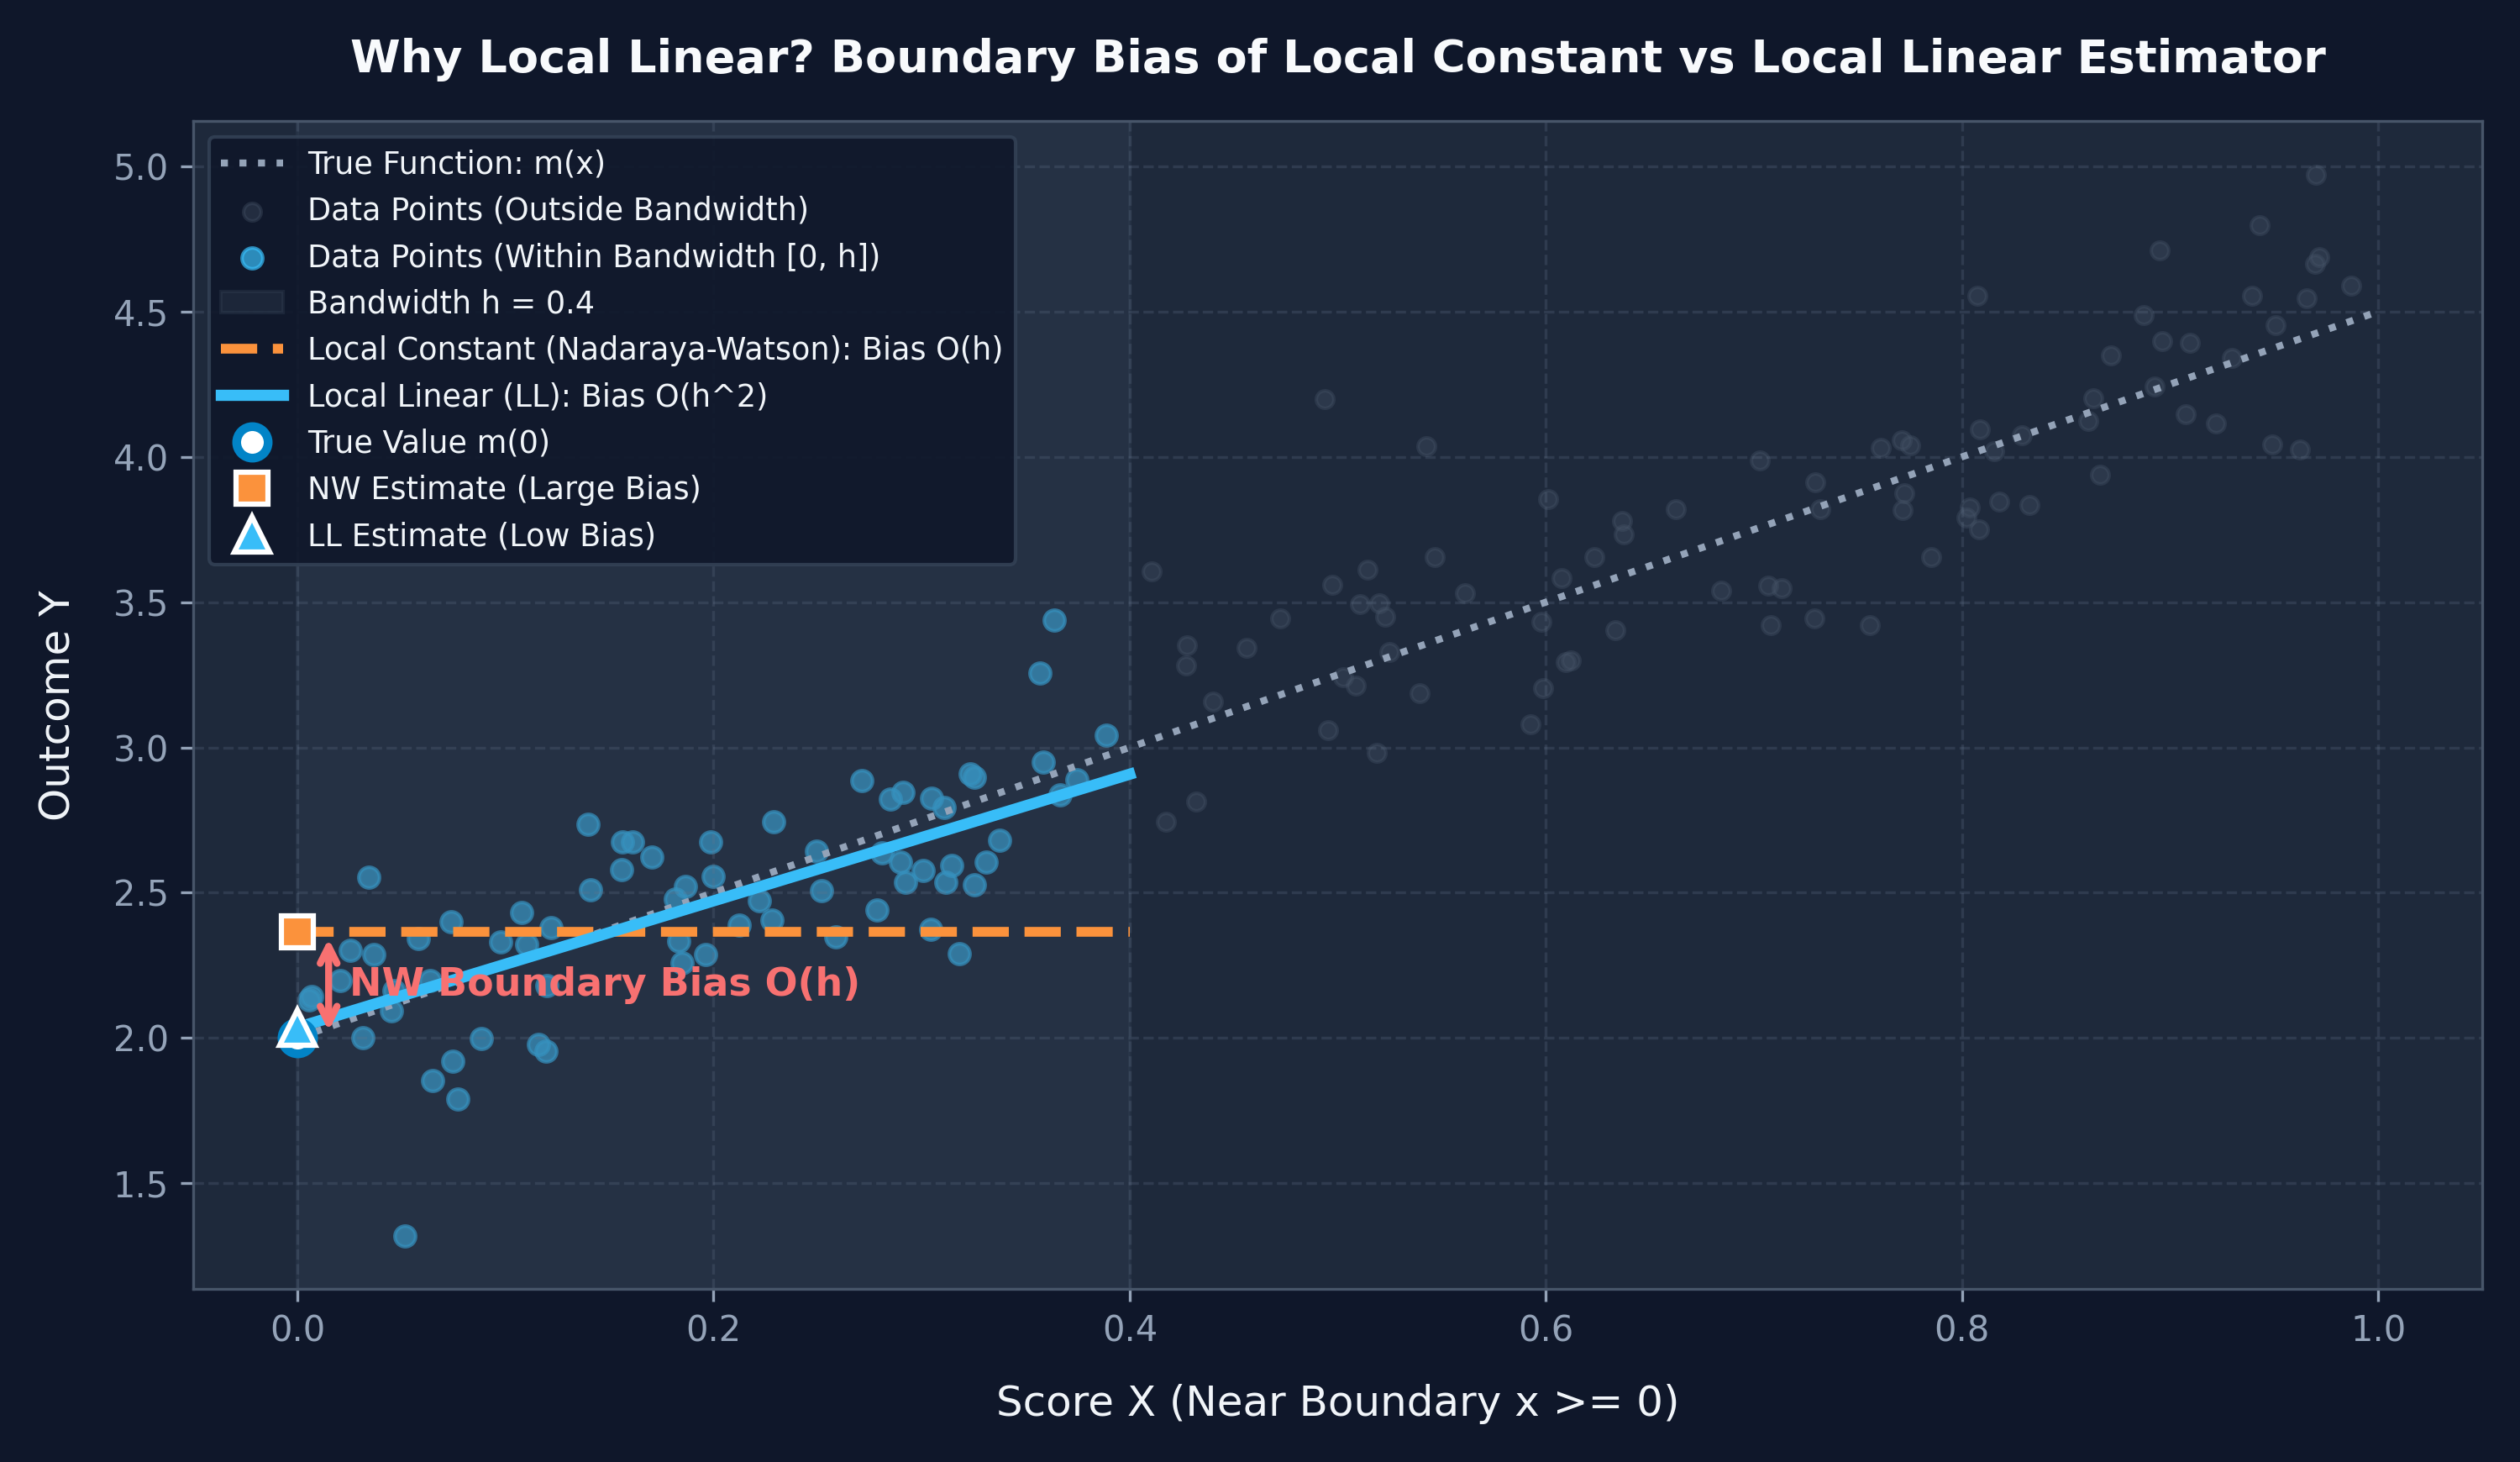
τ ^ r d d = μ ^ + − μ ^ − \hat{\tau}_{rdd} = \hat{\mu}_+ - \hat{\mu}_- τ ^ r dd = μ ^ + − μ ^ − ここで、なぜ通常の局所定数推定量(Nadaraya-Watson推定量; NW)ではなく、局所線形(Local Linear; LL)回帰 が業界標準として使われるのでしょうか?
【数式による行間埋め:NW推定量とLL推定量の境界バイアスの違い】
カットオフ c c c X i ≥ c X_i \ge c X i ≥ c c = 0 c = 0 c = 0 X i ≥ 0 X_i \ge 0 X i ≥ 0
カーネル関数を K ( u ) K(u) K ( u ) h h h
γ j = ∫ 0 ∞ u j K ( u ) d u ( j = 0 , 1 , 2 , … ) \gamma_j = \int_{0}^{\infty} u^j K(u) \, du \quad (j = 0, 1, 2, \dots) γ j = ∫ 0 ∞ u j K ( u ) d u ( j = 0 , 1 , 2 , … ) 通常の内部点(interior point)ではカーネルが対称であるため奇数次モーメント(∫ − ∞ ∞ u K ( u ) d u \int_{-\infty}^{\infty} u K(u) du ∫ − ∞ ∞ u K ( u ) d u 0 0 0 片側積分となるため γ 1 ≠ 0 \gamma_1 \neq 0 γ 1 = 0 となります!
Nadaraya-Watson(局所定数)の場合:
テイラー展開 μ ( X i ) = μ ( 0 ) + μ ′ ( 0 + ) X i + 1 2 μ ′ ′ ( 0 + ) X i 2 + o ( X i 2 ) \mu(X_i) = \mu(0) + \mu'(0^+) X_i + \frac{1}{2}\mu''(0^+) X_i^2 + o(X_i^2) μ ( X i ) = μ ( 0 ) + μ ′ ( 0 + ) X i + 2 1 μ ′′ ( 0 + ) X i 2 + o ( X i 2 )
B i a s N W ( μ ^ + ) = E [ μ ^ + ] − μ ( 0 + ) = h ⋅ γ 1 γ 0 μ ′ ( 0 + ) + O ( h 2 ) \mathrm{Bias}_{\mathrm{NW}}(\hat{\mu}_+) = \mathbb{E}[\hat{\mu}_+] - \mu(0^+) = h \cdot \frac{\gamma_1}{\gamma_0} \mu'(0^+) + O(h^2) Bias NW ( μ ^ + ) = E [ μ ^ + ] − μ ( 0 + ) = h ⋅ γ 0 γ 1 μ ′ ( 0 + ) + O ( h 2 ) なんと、1次の導関数 μ ′ ( 0 + ) \mu'(0^+) μ ′ ( 0 + ) O ( h ) O(h) O ( h ) が残留してしまうのです!これを境界バイアス(boundary bias) と呼びます。
局所線形(LL)回帰の場合:
局所線形回帰は、カットオフ近傍で直線 α + β ( X i − c ) \alpha + \beta (X_i - c) α + β ( X i − c ) β \beta β μ ′ ( 0 + ) \mu'(0^+) μ ′ ( 0 + )
B i a s L L ( μ ^ + ) = h 2 ⋅ γ 2 2 − γ 1 γ 3 2 ( γ 0 γ 2 − γ 1 2 ) μ ′ ′ ( 0 + ) + o ( h 2 ) ≡ h 2 2 κ 2 ∗ ( k ∗ ) μ ′ ′ ( c + ) \mathrm{Bias}_{\mathrm{LL}}(\hat{\mu}_+) = h^2 \cdot \frac{\gamma_2^2 - \gamma_1 \gamma_3}{2(\gamma_0 \gamma_2 - \gamma_1^2)} \mu''(0^+) + o(h^2) \equiv \frac{h^2}{2} \kappa_2^*(k^*) \mu''(c_+) Bias LL ( μ ^ + ) = h 2 ⋅ 2 ( γ 0 γ 2 − γ 1 2 ) γ 2 2 − γ 1 γ 3 μ ′′ ( 0 + ) + o ( h 2 ) ≡ 2 h 2 κ 2 ∗ ( k ∗ ) μ ′′ ( c + ) 左右の差をとることで、テキスト p.66 に記載された以下の美しいバイアス・分散構造が導かれます:
E [ τ ^ r d d − τ r d d ∣ X ] ≈ h 2 2 κ 2 ∗ ( k ∗ ) ( μ ′ ′ ( c + ) − μ ′ ′ ( c − ) ) ≡ B ( h ) V a r [ τ ^ r d d ∣ X ] ≈ R ∗ ( k ∗ ) n h ( σ 2 ( c + ) f ( c + ) + σ 2 ( c − ) f ( c − ) ) ≡ V ( h ) \begin{aligned}
\mathbb{E}[\hat{\tau}_{rdd} - \tau_{rdd} \mid \boldsymbol{X}] &\approx \frac{h^2}{2} \kappa_2^*(k^*) \left( \mu''(c_+) - \mu''(c_-) \right) \equiv B(h) \\
\mathrm{Var}[\hat{\tau}_{rdd} \mid \boldsymbol{X}] &\approx \frac{R^*(k^*)}{nh} \left( \frac{\sigma^2(c_+)}{f(c_+)} + \frac{\sigma^2(c_-)}{f(c_-)} \right) \equiv V(h)
\end{aligned} E [ τ ^ r dd − τ r dd ∣ X ] Var [ τ ^ r dd ∣ X ] ≈ 2 h 2 κ 2 ∗ ( k ∗ ) ( μ ′′ ( c + ) − μ ′′ ( c − ) ) ≡ B ( h ) ≈ nh R ∗ ( k ∗ ) ( f ( c + ) σ 2 ( c + ) + f ( c − ) σ 2 ( c − ) ) ≡ V ( h ) 局所線形回帰を採用することで、境界バイアスのオーダーを O ( h ) O(h) O ( h ) O ( h 2 ) O(h^2) O ( h 2 )
2. Calonico et al. (2014) のバイアス修正と「失われた分散」W ( h , b ) W(h, b) W ( h , b )
次に、点推定と区間推定の間に横たわる深刻な矛盾を解剖します。
なぜ MSE 最小化バンド幅を使うと Wald 信頼区間が崩壊するのか?
漸近平均二乗誤差 A M S E ( h ) = B ( h ) 2 + V ( h ) = O ( h 4 ) + O ( ( n h ) − 1 ) \mathrm{AMSE}(h) = B(h)^2 + V(h) = O(h^4) + O((nh)^{-1}) AMSE ( h ) = B ( h ) 2 + V ( h ) = O ( h 4 ) + O (( nh ) − 1 ) h M S E h_{\mathrm{MSE}} h MSE
d d h ( C 1 h 4 + C 2 n h ) = 0 ⟹ h M S E ∝ n − 1 / 5 \frac{d}{dh} \left( C_1 h^4 + \frac{C_2}{nh} \right) = 0 \implies h_{\mathrm{MSE}} \propto n^{-1/5} d h d ( C 1 h 4 + nh C 2 ) = 0 ⟹ h MSE ∝ n − 1/5 が得られます。
この h ∝ n − 1 / 5 h \propto n^{-1/5} h ∝ n − 1/5 n h \sqrt{nh} nh V ( h ) ∼ O ( ( n h ) − 1 / 2 ) \sqrt{V(h)} \sim O((nh)^{-1/2}) V ( h ) ∼ O (( nh ) − 1/2 )
τ ^ r d d − τ r d d V ( h ) = τ ^ r d d − E [ τ ^ r d d ] V ( h ) ⏟ → d N ( 0 , 1 ) + B ( h ) V ( h ) ⏟ 漸近バイアス項 \frac{\hat{\tau}_{rdd} - \tau_{rdd}}{\sqrt{V(h)}} = \underbrace{\frac{\hat{\tau}_{rdd} - \mathbb{E}[\hat{\tau}_{rdd}]}{\sqrt{V(h)}}}_{\xrightarrow{d} N(0, 1)} + \underbrace{\frac{B(h)}{\sqrt{V(h)}}}_{\text{漸近バイアス項}} V ( h ) τ ^ r dd − τ r dd = d N ( 0 , 1 ) V ( h ) τ ^ r dd − E [ τ ^ r dd ] + 漸近バイアス項 V ( h ) B ( h ) ここで第2項のオーダーを評価すると:
B ( h ) V ( h ) = O ( h 2 ) O ( ( n h ) − 1 / 2 ) = O ( n h 5 ) \frac{B(h)}{\sqrt{V(h)}} = \frac{O(h^2)}{O((nh)^{-1/2})} = O(\sqrt{n h^5}) V ( h ) B ( h ) = O (( nh ) − 1/2 ) O ( h 2 ) = O ( n h 5 ) もし h ∝ n − 1 / 5 h \propto n^{-1/5} h ∝ n − 1/5 n h 5 = O ( 1 ) n h^5 = O(1) n h 5 = O ( 1 ) 漸近バイアスが消えずに非ゼロの定数として生き残ってしまいます!
τ ^ r d d − τ r d d V ( h ) → d N ( Bias , 1 ) ≠ N ( 0 , 1 ) \frac{\hat{\tau}_{rdd} - \tau_{rdd}}{\sqrt{V(h)}} \xrightarrow{d} N(\text{Bias}, 1) \neq N(0, 1) V ( h ) τ ^ r dd − τ r dd d N ( Bias , 1 ) = N ( 0 , 1 ) その結果、中心がズレた正規分布に基づいて作られた通常の信頼区間 [ τ ^ r d d ± 1.96 V ^ ( h ) ] [\hat{\tau}_{rdd} \pm 1.96 \sqrt{\hat{V}(h)}] [ τ ^ r dd ± 1.96 V ^ ( h ) ] 95 % 95\% 95%
バイアスを消すには n h 5 → 0 ⟺ n h 5 → 0 \sqrt{nh^5} \to 0 \iff nh^5 \to 0 n h 5 → 0 ⟺ n h 5 → 0 h ≪ n − 1 / 5 h \ll n^{-1/5} h ≪ n − 1/5
ロバスト・バイアス修正(RBC)のブレークスルー
そこで Calonico, Cattaneo, and Titiunik (2014, CCT) は、バイアスそのものを局所2次(あるいは高次)多項式回帰によってパイロットバンド幅 b b b
τ ^ r d d b c = τ ^ r d d ( h ) − B ^ ( h , b ) \hat{\tau}_{rdd}^{bc} = \hat{\tau}_{rdd}(h) - \hat{B}(h, b) τ ^ r dd b c = τ ^ r dd ( h ) − B ^ ( h , b ) ここで極めて重要なのが、教科書 p.67 にサラリと書かれている追加分散 W ( h , b ) W(h, b) W ( h , b ) です。
従来の統計学者は「バイアス推定量 B ^ ( h , b ) \hat{B}(h, b) B ^ ( h , b ) B ^ ( h , b ) \hat{B}(h, b) B ^ ( h , b ) 確率変数 です。したがって:
V a r [ τ ^ r d d b c ] = V a r [ τ ^ r d d ( h ) ] + V a r [ B ^ ( h , b ) ] − 2 C o v ( τ ^ r d d ( h ) , B ^ ( h , b ) ) \mathrm{Var}[\hat{\tau}_{rdd}^{bc}] = \mathrm{Var}[\hat{\tau}_{rdd}(h)] + \mathrm{Var}[\hat{B}(h, b)] - 2 \mathrm{Cov}(\hat{\tau}_{rdd}(h), \hat{B}(h, b)) Var [ τ ^ r dd b c ] = Var [ τ ^ r dd ( h )] + Var [ B ^ ( h , b )] − 2 Cov ( τ ^ r dd ( h ) , B ^ ( h , b )) となり、バイアス推定に起因するサンプリング誤差が分散を押し上げます。この正味の追加分散こそが:
V b c ( h , b ) = V ( h ) + W ( h , b ) V^{bc}(h, b) = V(h) + W(h, b) V b c ( h , b ) = V ( h ) + W ( h , b ) の W ( h , b ) W(h, b) W ( h , b ) W ( h , b ) W(h, b) W ( h , b )
τ ^ r d d b c − τ r d d V ^ b c ( h , b ) → d N ( 0 , 1 ) \frac{\hat{\tau}_{rdd}^{bc} - \tau_{rdd}}{\sqrt{\hat{V}^{bc}(h, b)}} \xrightarrow{d} N(0, 1) V ^ b c ( h , b ) τ ^ r dd b c − τ r dd d N ( 0 , 1 ) が成立することを証明し、現代の R パッケージ rdrobust のデファクトスタンダードを打ち立てました。
3. Kolesár and Rothe (2018) の「オネスト(偽りのない)信頼区間」の深層
テキスト p.68〜p.70 では、さらに進んだアプローチとして Kolesár and Rothe (2018) の議論が展開されています。
なぜ CCT のバイアス修正ですら不十分であり得るのでしょうか?それは「一様性(Uniformity)」 の問題です。
通常の漸近論は、真の回帰関数 μ ( x ) \mu(x) μ ( x ) 1 1 1 n → ∞ n \to \infty n → ∞
lim n → ∞ P μ ( τ r d d ∈ C I ) ≥ 1 − α ( ∀ μ ∈ M ) \lim_{n \to \infty} P_{\mu}(\tau_{rdd} \in \mathrm{CI}) \ge 1 - \alpha \quad (\forall \mu \in \mathcal{M}) n → ∞ lim P μ ( τ r dd ∈ CI ) ≥ 1 − α ( ∀ μ ∈ M ) しかし、実務の有限サンプル n n n μ ( x ) \mu(x) μ ( x ) x = c x=c x = c n n n 1 − α 1-\alpha 1 − α μ ∈ M \mu \in \mathcal{M} μ ∈ M
inf μ ∈ M P μ ( τ r d d ∈ C I ) < 1 − α − ε \inf_{\mu \in \mathcal{M}} P_{\mu}(\tau_{rdd} \in \mathrm{CI}) < 1 - \alpha - \varepsilon μ ∈ M inf P μ ( τ r dd ∈ CI ) < 1 − α − ε これでは「実務で手元にあるデータにおいて信頼区間が信用できるか」が保証されません。
そこで Kolesár and Rothe は、回帰関数の2階導関数が定数 K K K
M = { μ : ∣ μ ′ ( a ) − μ ′ ( b ) ∣ ≤ K ∣ a − b ∣ , ∀ a , b < c and ∀ a , b > c } \mathcal{M} = \{ \mu : |\mu'(a) - \mu'(b)| \le K |a - b|, \forall a, b < c \text{ and } \forall a, b > c \} M = { μ : ∣ μ ′ ( a ) − μ ′ ( b ) ∣ ≤ K ∣ a − b ∣ , ∀ a , b < c and ∀ a , b > c } を想定し、このクラス M \mathcal{M} M 一様に(Uniformly) 信頼区間が被覆確率を保証する条件を課しました:
lim n → ∞ inf μ ∈ M P μ ( τ r d d ∈ C I ) ≥ 1 − α \lim_{n \to \infty} \inf_{\mu \in \mathcal{M}} P_{\mu}(\tau_{rdd} \in \mathrm{CI}) \ge 1 - \alpha n → ∞ lim μ ∈ M inf P μ ( τ r dd ∈ CI ) ≥ 1 − α これこそが「オネスト(偽りのない)信頼区間」 の定義です。
オネスト信頼区間の構築ステップ
Kolesár and Rothe はバイアスを「推計して引く」のではなく、「最悪の場合のバイアスの絶対上限 r s u p r_{\mathrm{sup}} r sup という驚くべき発想をとります。
局所線形推定量 τ ^ h \hat{\tau}_h τ ^ h τ ˉ h = E [ τ ^ h ∣ X ] \bar{\tau}_h = \mathbb{E}[\hat{\tau}_h \mid \boldsymbol{X}] τ ˉ h = E [ τ ^ h ∣ X ] σ ^ / n h \hat{\sigma}/\sqrt{n_h} σ ^ / n h
規格化された推定量は次のように分解される:
n h ( τ ^ h − τ r d d ) σ ^ = n h ( τ ^ h − τ ˉ h ) σ ^ ⏟ ∼ N ( 0 , 1 ) + n h ( τ ˉ h − τ r d d ) σ ^ ⏟ 有限サンプルの正規化バイアス r \frac{\sqrt{n_h}(\hat{\tau}_h - \tau_{rdd})}{\hat{\sigma}} = \underbrace{\frac{\sqrt{n_h}(\hat{\tau}_h - \bar{\tau}_h)}{\hat{\sigma}}}_{\sim N(0, 1)} + \underbrace{\frac{\sqrt{n_h}(\bar{\tau}_h - \tau_{rdd})}{\hat{\sigma}}}_{\text{有限サンプルの正規化バイアス } r} σ ^ n h ( τ ^ h − τ r dd ) = ∼ N ( 0 , 1 ) σ ^ n h ( τ ^ h − τ ˉ h ) + 有限サンプルの正規化バイアス r σ ^ n h ( τ ˉ h − τ r dd )
最悪の関数 μ ∈ M \mu \in \mathcal{M} μ ∈ M
r s u p ≡ sup μ ∈ M n h ∣ τ ˉ h − τ r d d ∣ σ ^ r_{\mathrm{sup}} \equiv \sup_{\mu \in \mathcal{M}} \frac{\sqrt{n_h}|\bar{\tau}_h - \tau_{rdd}|}{\hat{\sigma}} r sup ≡ μ ∈ M sup σ ^ n h ∣ τ ˉ h − τ r dd ∣
統計量 ∣ n h ( τ ^ h − τ r d d ) σ ^ ∣ \left| \frac{\sqrt{n_h}(\hat{\tau}_h - \tau_{rdd})}{\hat{\sigma}} \right| σ ^ n h ( τ ^ h − τ r dd ) r s u p r_{\mathrm{sup}} r sup 1 1 1 ∣ N ( r s u p , 1 ) ∣ |N(r_{\mathrm{sup}}, 1)| ∣ N ( r sup , 1 ) ∣
したがって、この折返し正規分布の 1 − α 1-\alpha 1 − α c v 1 − α ( r s u p ) cv_{1-\alpha}(r_{\mathrm{sup}}) c v 1 − α ( r sup )
C I = [ τ ^ h − c v 1 − α ( r s u p ) σ ^ n h , τ ^ h + c v 1 − α ( r s u p ) σ ^ n h ] \mathrm{CI} = \left[ \hat{\tau}_h - cv_{1-\alpha}(r_{\mathrm{sup}}) \frac{\hat{\sigma}}{\sqrt{n_h}}, \; \hat{\tau}_h + cv_{1-\alpha}(r_{\mathrm{sup}}) \frac{\hat{\sigma}}{\sqrt{n_h}} \right] CI = [ τ ^ h − c v 1 − α ( r sup ) n h σ ^ , τ ^ h + c v 1 − α ( r sup ) n h σ ^ ] として完全に解析的に求まります!
なぜ著者はこのような説明・省略をしたのか?(統計学的考察)
テキスト p.70 の冒頭には、極めて鋭く、かつ教育的な注意書きがなされています:
「Kolesár and Rothe (2018) の信頼区間が偽りのないものであるために重要な点は、分析者がデータに依存せずに K K K K K K
多くのデータサイエンティストは「ハイパーパラメータ K K K 「データから推定してはならない」 と強く釘を刺しているのでしょうか?
1. 「ただ飯(Free Lunch)」は存在しないという数理的真理
もし曲率の上限 K K K K K K K ^ \hat{K} K ^ 「曲率の事前制約なしに、一様に妥当なオネスト信頼区間をデータ駆動のみで構成することは数学的に不可能」 なのです。カバレッジの保証を得るためには、分析者が「真の関数は少なくともこの定数 K K K
2. センシティビティ・アナリシス(感度分析)としての思想
だからこそ、教科書は「K K K K = 0 K=0 K = 0 K K K
まとめ & 関連する問い
本稿で解き明かした RDD の数理構造を総括します:
局所線形(LL)回帰の必然性 : カットオフ境界において、局所定数推定量(NW)が抱える O ( h ) O(h) O ( h ) O ( h 2 ) O(h^2) O ( h 2 ) 点推定と区間推定の乖離 : AMSE最適バンド幅 h ∝ n − 1 / 5 h \propto n^{-1/5} h ∝ n − 1/5 n h 5 → C > 0 nh^5 \to C > 0 n h 5 → C > 0 W ( h , b ) W(h, b) W ( h , b ) オネスト推論の境地 : 点ごとの漸近論の限界を超え、有限サンプルで一様にカバレッジを保証するために、Kolesár and Rothe (2018) は最悪バイアス境界 r s u p r_{\mathrm{sup}} r sup
さらなる発展的課題
離散スコア(Discrete Running Variables)への拡張 :
本テキストでも言及されている通り、Kolesár and Rothe の手法の最大の強みは h → 0 h \to 0 h → 0 X i X_i X i Fuzzy RDD(不完全遵守)における操作変数法との結合 :
処置割り当て確率がカットオフでジャンプするだけの「ファジーRDD」において、局所多項式回帰を用いた局所2段階最小二乗法(Local 2SLS)のバイアス修正とオネスト推論はどのように定式化されるでしょうか?
計量経済学と統計学が交差する因果推論の最前線では、単なる回帰分析の枠を超えた深遠なノンパラメトリック理論が息づいています。数式の行間に込められた先人たちの知恵を紐解くことで、現場でのデータ分析はより堅牢で説得力のあるものへと昇華されるはずです。
🔗 あわせて読みたい当ブログの関連記事
📚 参考文献・関連文献
末石直也 (2021). 『データ駆動型回帰分析――計量経済学と機械学習の融合』, 日本評論社. (第3章「回帰不連続デザイン」)
Calonico, S., Cattaneo, M. D., & Titiunik, R. (2014). “Robust nonparametric confidence intervals for regression-discontinuity designs.” Econometrica , 82(6), 2295-2326.
Kolesár, M., & Rothe, C. (2018). “Inference in regression discontinuity designs with a discrete running variable.” American Economic Review , 108(8), 2277-2304.
Armstrong, T. B., & Kolesár, M. (2018). “Optimal inference in a class of minimax problems.” Econometrica , 86(2), 655-683.
Fan, J., & Gijbels, I. (1996). Local Polynomial Modelling and Its Applications . Chapman & Hall/CRC.
📝 ノート作成メモ
本記事は統計学・データサイエンスの教科書における数式導出や概念の行間を補完するために Gemini マルチモーダル解析によって生成・整理された解説です。