導入(1行サマリー & つかみ)
「閾値の直前と直後を比べるだけで因果効果がわかる」という直観的な魅力の裏には、ノンパラメトリック推定における深刻な境界バイアスと推測の破綻という数理的な難問が横たわっています。
実証計量経済学やデータサイエンスの現場において、回帰不連続デザイン(Regression Discontinuity Design, RDD)は、ランダム化比較試験(RCT)に匹敵する内的妥当性を持つ「準実験手法の最高峰」として確固たる地位を築いてきました。試験の合格最低点、補助金給付の所得制限ライン、Webサービスにおける施策の配信判定スコア閾値――人間社会の意思決定やアルゴリズムは、非連続な境界線(カットオフ)に満ちています。
しかし、境界線近傍のデータを単純に回帰分析にかけるだけでは、因果の真実には到達できません。今回取り上げる文献『データ駆動型回帰分析』の抜粋(第3章 ノンパラメトリック回帰:3.3 回帰不連続デザイン・3.4 補論)は、カットオフにおける平均処置効果の識別理論から、局所線形(Local Linear, LL)推定量、現代の実証分析で事実上の標準である Calonico, Cattaneo, and Titiunik (2014) の頑健バイアス修正法、さらには Kolesár and Rothe (2018) が提起した「オネスト(偽りのない)信頼区間」に至るフロンティアを鮮やかに凝縮しています。
かつて当ブログの過去記事である 境界の不連続性に宿る因果の光:回帰不連続デザイン(RDD)の識別論理と推測数理を解き明かす や 回帰不連続デザイン(RDD)における識別と漸近推測の深淵:局所線形回帰のバイアス修正とオネスト信頼区間の行間を解剖する でも論じたように、RDDの本質は「局所的な自然の実験」を切り出す点にあります。本稿ではさらに一歩踏み込み、実証分析者が直面する「バンド幅選択のジレンマ」「漸近バイアス」「被覆確率の崩壊」という数理的病理と、現代計量経済学がそれをどう克服したのかを、数式展開の行間を丁寧に補いながらステップ・バイ・ステップで徹底解剖します。
識別の壁と因果推論の課題
因果効果を測定しようとする試みは、常に「選択バイアス(Selection Bias)」 との闘いです。
たとえば、ある大学入試の合格が将来の所得に与える因果的効果を評価したいとします。合格者グループと不合格者グループの将来賃金を単純に比較しても、それは大学教育の真の効果を表しません。合格者はもともとの学力が高く、家庭環境や学習習慣といった観察不能な資質(交絡因子)に恵まれている可能性が高いためです。
このとき、合格・不合格を分ける試験スコア(強制変数・ランニング変数 / Running Variable, Forcing Variable)を X i X_i X i c c c
シャープな RDD(Sharp RDD)とは何か?:決定論的割り当てと「ファジー」との違い
回帰不連続デザイン(RDD)は、カットオフ c c c 「シャープな RDD(Sharp RDD)」 と「ファジーな RDD(Fuzzy RDD)」 の2種類に大別されます。
1. シャープな RDD の定義:100% 決定論的な世界の境界線
シャープな RDD とは、ランニング変数 X i X_i X i c c c D i ∈ { 0 , 1 } D_i \in \{0, 1\} D i ∈ { 0 , 1 } 「例外なく 100% 決定論的(Deterministic)」 に二分されるデザインです。
数式では、指示関数 1 ( ⋅ ) \mathbf{1}(\cdot) 1 ( ⋅ )
D i = 1 ( X i ≥ c ) = { 1 ( X i ≥ c ) 0 ( X i < c ) D_i = \mathbf{1}(X_i \ge c) = \begin{cases} 1 & (X_i \ge c) \\ 0 & (X_i < c) \end{cases} D i = 1 ( X i ≥ c ) = { 1 0 ( X i ≥ c ) ( X i < c ) ここで極めて重要なのは、「カットオフを跨いだ瞬間に、処置を受ける確率 P ( D i = 1 ∣ X i = x ) P(D_i = 1 \mid X_i = x) P ( D i = 1 ∣ X i = x ) 0 0 0 1 1 1 という点です。個人の好み、担当者の裁量、例外的な裏口や辞退といった「不遵守(Non-compliance)」が一切許されない厳格な制度設計を前提とします。
現実における具体例 :
アルゴリズムの自動判定 :信用スコアが700点以上なら即座に融資承認(D = 1 D=1 D = 1 D = 0 D=0 D = 0 法律上の絶対的年齢閾値 :20歳の誕生日を迎えた瞬間に選挙権や飲酒が法的に解禁される(19歳364日は0%、20歳0日は100%)選挙の過半数ルール :得票率が50%を1票でも上回れば確実に当選(D = 1 D=1 D = 1 D = 0 D=0 D = 0
2. ファジーな RDD(Fuzzy RDD)との決定的な違い
一方で、現実の社会政策や実証研究では「ルール通りにいかない人間行動」がしばしば現れます。
たとえば、「大学入試に合格(X i ≥ c X_i \ge c X i ≥ c X i < c X_i < c X i < c
このように、カットオフを境に処置の受給確率は不連続に変化するものの、0 → 1 0 \to 1 0 → 1 0.2 → 0.8 0.2 \to 0.8 0.2 → 0.8 「確率的な段差(受給確率のジャンプ)」 に留まる状況をファジーな RDD(Fuzzy RDD) と呼びます。
比較項目 シャープな RDD(Sharp RDD) ファジーな RDD(Fuzzy RDD) 処置割り当てのルール 決定論的(Deterministic) 確率的(Probabilistic) 処置確率のジャンプ幅 0 → 1 0 \to 1 0 → 1 0 % → 100 % 0\% \to 100\% 0% → 100% P + − P − < 1 P_+ - P_- < 1 P + − P − < 1 20 % → 80 % 20\% \to 80\% 20% → 80% 個体の遵守状況 完全遵守(例外・不遵守・辞退がゼロ) 不完全遵守(辞退者・不遵守者が混在) 識別される因果効果 境界における平均処置効果(ATE at Cutoff) 境界における局所的平均処置効果(LATE: 遵守者効果) 分析アプローチ カットオフ極限の差:μ + − μ − \mu_+ - \mu_- μ + − μ − 操作変数法(IV / 2SLS):結果変数のジャンプ 処置確率のジャンプ \frac{\text{結果変数のジャンプ}}{\text{処置確率のジャンプ}} 処置確率のジャンプ 結果変数のジャンプ
本稿のスコープ
現実の不完全遵守を扱うファジーな RDD は操作変数法(IV)の枠組みへと拡張されますが、回帰不連続デザインの「因果識別の中核論理」「境界バイアスの克服」「統計的推測の厳密化」 という数理的エッセンスは、すべてシャープな RDD に凝縮されています。そのため、本書(第3章3.3節)および本稿では、議論の基礎にして最重要モデルであるシャープな RDD に焦点を絞って理論を解剖していきます。
ここで、ネイマン=ルービンの潜在的結果モデル(Potential Outcomes Framework)を導入します。個体 i i i Y i ( 1 ) Y_i(1) Y i ( 1 ) Y i ( 0 ) Y_i(0) Y i ( 0 ) Y i Y_i Y i
Y i = ( 1 − D i ) Y i ( 0 ) + D i Y i ( 1 ) Y_i = (1 - D_i) Y_i(0) + D_i Y_i(1) Y i = ( 1 − D i ) Y i ( 0 ) + D i Y i ( 1 ) オーバーラップ条件の完全な崩壊:「同じ特徴なのに結果が違うペア」が1人も存在しない罠
通常、観察データからマッチング法や傾向スコア法、回帰分析で因果効果を公平に比較するためには、「オーバーラップ(共通台)条件(Overlap / Common Support / Positivity)」 という大前提が必要です。
オーバーラップ条件とは何か?
一言で言えば、「同じような特徴(年齢・学力・性別など)を持った人が、処置を受けたグループ(処置群)と受けなかったグループ(対照群)の『双方』に存在していなければならない」 という要請です。
数式では次のように表現されます:
0 < P ( D i = 1 ∣ X i = x ) < 1 ( すべての x において ) 0 < P(D_i = 1 \mid X_i = x) < 1 \quad (\text{すべての } x \text{ において}) 0 < P ( D i = 1 ∣ X i = x ) < 1 ( すべての x において )
P ( D i = 1 ∣ X i = x ) > 0 P(D_i = 1 \mid X_i = x) > 0 P ( D i = 1 ∣ X i = x ) > 0 x x x 処置を受けた人が少なくとも1人いる P ( D i = 1 ∣ X i = x ) < 1 P(D_i = 1 \mid X_i = x) < 1 P ( D i = 1 ∣ X i = x ) < 1 x x x 処置を受けなかった人(対照群)も少なくとも1人いる
たとえば、「ある新薬の効果」を検証したいとき、データの中で「80代の高齢者は全員が新薬を投与され、20代の若者は全員が投与されなかった」としたらどうでしょうか?
年齢の影響を揃えて比較しようとしても、データの中に「80代の非投与者」も「20代の投与者」も1人もいないため、年齢の分布が一切重ならず(オーバーラップせず)、新薬が効いたのか単なる若さのせいなのか原理的に区別(識別)できません。公平な比較をするためには、どんな特徴 x x x 比較の相手(ペア) が両群に存在している必要があります。
RDD においてオーバーラップが「完全に破綻」する理由
しかし、シャープな RDD(Sharp RDD)では、制度のカットオフ値 c c c
X i < c X_i < c X i < c 完全に 0 % 0\% 0% (合格者は 0 0 0 X i ≥ c X_i \ge c X i ≥ c 完全に 100 % 100\% 100% (不合格者は 0 0 0
つまり、「同じ点数 x x x 。
スコア空間のいかなる点 x x x 「識別の壁」 です。同じ特徴を持つ個体同士をマッチングして比べるという王道の手法は、ここでは完全に無力化されます。
連続性仮定による識別の跳躍
この決定論的割り当ての壁を突破するために導入されるのが、Hahn, Todd, and van der Klaauw (2001) によって定式化された潜在的結果の条件付期待値の連続性仮定(Continuity Assumption) です。
仮定: E [ Y i ( 1 ) ∣ X i = x ] および E [ Y i ( 0 ) ∣ X i = x ] が x = c において x に関して連続 \text{仮定: } \mathbb{E}[Y_i(1) \mid X_i = x] \quad \text{および} \quad \mathbb{E}[Y_i(0) \mid X_i = x] \quad \text{が } x = c \text{ において } x \text{ に関して連続} 仮定 : E [ Y i ( 1 ) ∣ X i = x ] および E [ Y i ( 0 ) ∣ X i = x ] が x = c において x に関して連続 この仮定が意味するのは、「もし合格最低点をわずか1点差で下回った受験生が仮に合格していたら、その期待賃金は1点差でギリギリ合格した受験生と等しかったはずだ」という反実仮想の滑らかさです。学力や家庭環境などの交絡因子の分布がカットオフ c c c
補足コラム:内的妥当性(Internal Validity)とは何か?
導入部で「RDDはランダム化比較試験(RCT)に匹敵する内的妥当性を誇る」と述べましたが、計量経済学における「内的妥当性(Internal Validity)」 と、その対になる「外的妥当性(External Validity)」 の違いを整理しておきましょう。
概念 核心となる問い 焦点・意味 主な脅威(バイアス) 内的妥当性 「この分析結果は、対象サンプル内で本当に真の因果効果を捉えているか?」 選択バイアスや未観測の交絡因子が排除され、「処置 D i D_i D i Y i Y_i Y i 。 ・未観測の交絡(能力・意欲など) 外的妥当性 「この分析で得られた効果は、他の人々や別の環境にも当てはまるか?」 分析で得られた因果的結論を、他の母集団・別の地域・将来の時代へと一般化(外挿: Extrapolation)できる度合い 。 ・サンプルの特殊性
なぜ RDD は「内的妥当性が極めて高い」のか?
通常の実証データ(観察研究)では、「高学歴な人ほど高収入」という相関を見ても、「もともと地頭が良く努力家だったから稼げているだけではないか(能力バイアス)」という疑念を完全に払拭することは極めて困難です。
しかし、RDD では「合格点 c c c
c − ε c - \varepsilon c − ε c + ε c + \varepsilon c + ε このわずか数点(あるいは1点)の差は、本人の知能や家庭環境の差ではなく、「試験当日の体調」「直前にヤマを張った問題が出たか」といったランダムな偶然(外生的なショック) によって決まったとみなせます。
したがって、カットオフの極近傍においては「神の手による無作為割付(準実験)」 が成立していることになり、未観測の交絡因子が左右で相殺されます。これが、RDD が観察研究の中で最も高い内的妥当性を誇る理由です。
RDD が抱える代償:外的妥当性とのトレードオフ
しかし、この高い内的妥当性と引き換えに、RDD は外的妥当性の限定 という代償を払っています。
後述するように、RDD で識別できるのは、あくまで「カットオフ値 X i = c X_i = c X i = c に限定されます。合格最低点ギリギリのボーダー層に対して教育効果があったとしても、90点で合格したトップ層や、20点しか取れなかった層にも同じ処置効果があるとは断言できません(外挿の限界)。
実証分析者は、この「内的妥当性の圧倒的な高さ」と「外的妥当性の局所性」のトレードオフを理解した上で RDD を活用する必要があります。
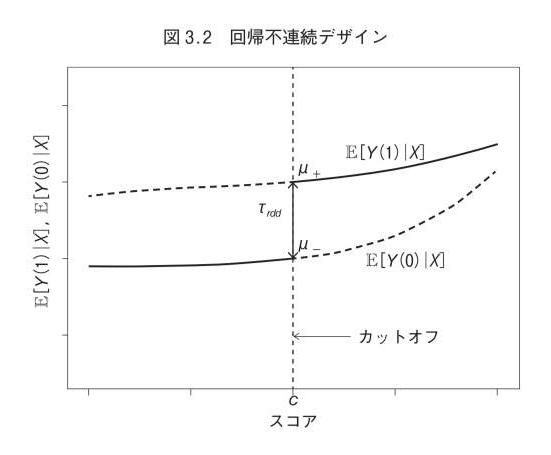
興味の対象であるカットオフ上の局所的平均処置効果(Local Average Treatment Effect at the Cutoff)τ r d d \tau_{\mathrm{rdd}} τ rdd
τ r d d ≡ E [ Y i ( 1 ) − Y i ( 0 ) ∣ X i = c ] \tau_{\mathrm{rdd}} \equiv \mathbb{E}[Y_i(1) - Y_i(0) \mid X_i = c] τ rdd ≡ E [ Y i ( 1 ) − Y i ( 0 ) ∣ X i = c ] 期待値の線形性より、これは次のように分解できます。
τ r d d = E [ Y i ( 1 ) ∣ X i = c ] − E [ Y i ( 0 ) ∣ X i = c ] \tau_{\mathrm{rdd}} = \mathbb{E}[Y_i(1) \mid X_i = c] - \mathbb{E}[Y_i(0) \mid X_i = c] τ rdd = E [ Y i ( 1 ) ∣ X i = c ] − E [ Y i ( 0 ) ∣ X i = c ] ここで連続性仮定を適用します。関数が x = c x = c x = c
E [ Y i ( 1 ) ∣ X i = c ] = lim x ↓ c E [ Y i ( 1 ) ∣ X i = x ] \mathbb{E}[Y_i(1) \mid X_i = c] = \lim_{x \downarrow c} \mathbb{E}[Y_i(1) \mid X_i = x] E [ Y i ( 1 ) ∣ X i = c ] = x ↓ c lim E [ Y i ( 1 ) ∣ X i = x ] E [ Y i ( 0 ) ∣ X i = c ] = lim x ↑ c E [ Y i ( 0 ) ∣ X i = x ] \mathbb{E}[Y_i(0) \mid X_i = c] = \lim_{x \uparrow c} \mathbb{E}[Y_i(0) \mid X_i = x] E [ Y i ( 0 ) ∣ X i = c ] = x ↑ c lim E [ Y i ( 0 ) ∣ X i = x ] さらに、観測される結果変数 Y i Y_i Y i x ≥ c x \ge c x ≥ c Y i ( 1 ) Y_i(1) Y i ( 1 ) x < c x < c x < c Y i ( 0 ) Y_i(0) Y i ( 0 ) Y i Y_i Y i
τ r d d = lim x ↓ c E [ Y i ∣ X i = x ] − lim x ↑ c E [ Y i ∣ X i = x ] ≡ μ + − μ − \begin{aligned}
\tau_{\mathrm{rdd}} &= \lim_{x \downarrow c} \mathbb{E}[Y_i \mid X_i = x] - \lim_{x \uparrow c} \mathbb{E}[Y_i \mid X_i = x] \\
&\equiv \mu_+ - \mu_-
\end{aligned} τ rdd = x ↓ c lim E [ Y i ∣ X i = x ] − x ↑ c lim E [ Y i ∣ X i = x ] ≡ μ + − μ −
上図(文献 p.65 図3.2 より)が示す通り、カットオフ c c c E [ Y i ( 0 ) ∣ X i ] \mathbb{E}[Y_i(0) \mid X_i] E [ Y i ( 0 ) ∣ X i ] E [ Y i ( 1 ) ∣ X i ] \mathbb{E}[Y_i(1) \mid X_i] E [ Y i ( 1 ) ∣ X i ] τ r d d \tau_{\mathrm{rdd}} τ rdd
核心理論と数理的メカニズム
識別が数理的に保証されたとしても、手元の有限標本データから右極限 μ + \mu_+ μ + μ − \mu_- μ −
文献(p.66「3.3.2 推定」)の冒頭には、次のような極めて重要かつ濃密な指針が示されています:
「これまでにいくつかの τ r d d \tau_{\mathrm{rdd}} τ rdd μ + \mu_+ μ + μ − \mu_- μ − E [ Y i ( 1 ) ∣ X i = x ] \mathbb{E}[Y_i(1) \mid X_i = x] E [ Y i ( 1 ) ∣ X i = x ] E [ Y i ( 0 ) ∣ X i = x ] \mathbb{E}[Y_i(0) \mid X_i = x] E [ Y i ( 0 ) ∣ X i = x ]
一見すると専門用語が凝縮されていますが、この一文には「なぜ全体ではなく近傍だけを見るのか?」「なぜ境界で普通の平均を取ると大失敗するのか?」「なぜ直線(LL)を当てはめると救われるのか?」 という、現代計量経済学の知恵が詰まっています。この背景を3つのポイントで紐解きましょう。
文献の記述を解剖する:なぜカーネル法とLL推定量が推奨されるのか?
1. なぜ全データではなく「カーネル法(局所推定)」なのか?
RDD を分析しようとするとき、初心者が真っ先に思いつきがちなのは「データ全体を使って高次の多項式回帰(3次式や4次式など)を引く」というアプローチです。
しかし、カットオフ c c c 「カットオフ直前・直後の境界線上の値」が大きく歪んでしまう(ルンゲ現象・外挿バイアス) ことが判明しています(Gelman and Imbens, 2019)。
私たちが真に知りたいのは、カットオフ c c c h h h 「カットオフに近いデータほど大きな重みを与え、遠いデータは無視する」 という局所的な重み付けを行う手法がカーネル法(Kernel Method) です。これが現代の実証分析におけるデファクトスタンダードとなっています。
2. 「カットオフは境界の点にあたる」とはどういう意味か?
通常の回帰分析や密度推定では、ある点 x x x 「左側にも右側にも」 バランスよくデータが存在します(これを内点(Interior Point) と呼びます)。
しかし、RDD のカットオフ c c c
合格者側の期待値 μ + \mu_+ μ + :データは X i ≥ c X_i \ge c X i ≥ c 1 1 1 不合格者側の期待値 μ − \mu_- μ − :データは X i < c X_i < c X i < c 1 1 1
つまり、カットオフ c c c 「データの崖っぷち・端っこ(境界点: Boundary Point)」 に位置しているのです。推定量は常に、片側からしかデータが得られないという過酷な条件下で境界の値を外挿・推定しなければなりません。
3. なぜ単なる平均ではなく「LL推定量(局所線形回帰)」が推奨されるのか?
「カットオフの近くにあるデータだけで単純に平均(重み付き平均)を取ればいいのでは?」と思うかもしれません。ノンパラメトリック統計におけるこの最も素朴な手法を局所定数推定量(Local Constant / Nadaraya-Watson 推定量) と呼びます。
しかし、境界(崖っぷち)でこの局所定数推定量を使うと、「深刻な境界バイアス(Boundary Bias)」 が発生します。
局所定数(ただの平均)の悲劇 :
いま、試験スコアと将来賃金の関係が「右肩上がり(坂道)」だったとします。
カットオフ c c c c c c 本来知りたい「カットオフ c c c 。
片側にしかデータがないため左右で傾きを相殺できず、このズレ(バイアス)はバンド幅 h h h O ( h ) O(h) O ( h )
局所線形(LL)推定量の鮮やかな解決 :
このバイアスを劇的に消し去るのが、局所線形(Local Linear, LL)推定量 です。
LL推定量は、近傍のデータを単に「水平な平均(定数)」で捉えるのではなく、「局所的な傾きを持った直線(Y = α + β ( X − c ) Y = \alpha + \beta(X - c) Y = α + β ( X − c ) を当てはめます。
直線の「傾き β \beta β 「坂道を滑り降りて、崖っぷちの境界 x = c x = c x = c α \alpha α ことができます。
この直線の当てはめにより、傾きに起因する1階微分のバイアスが数学的に自動相殺され、バイアスのオーダーは一気に O ( h 2 ) O(h^2) O ( h 2 )
さらに、回帰関数が強いカーブ(非線形性)を描いている場合には、2次式(放物線)を当てはめる2次以上の局所多項式推定量(Local Polynomial Estimator) を用いることで、曲率(2階微分)によるバイアスまでも相殺できるため、文献では「LL推定量、もしくは2次以上の局所多項式推定量」が強く推奨されているのです。
局所線形(Local Linear, LL)回帰の数学的定式化と境界バイアス
それでは、局所線形回帰の具体的な数理モデルを見ていきましょう。
カットオフの右側(X i ≥ c X_i \ge c X i ≥ c μ + \mu_+ μ +
1. 最小二乗問題の定式化:何をやっている数式なのか?
min α + , β + ∑ i : X i ≥ c ( Y i − α + − β + ( X i − c ) ) 2 k ( X i − c h ) \min_{\alpha_+, \beta_+} \sum_{i: X_i \ge c} \left( Y_i - \alpha_+ - \beta_+ (X_i - c) \right)^2 k\left( \frac{X_i - c}{h} \right) α + , β + min i : X i ≥ c ∑ ( Y i − α + − β + ( X i − c ) ) 2 k ( h X i − c ) この数式は、一見複雑に見えますが、やっていることは高校数学でもおなじみの「重み付きの直線あてはめ(最小二乗法)」 そのものです。各パーツの意味を分解しましょう:
直線モデル α + + β + ( X i − c ) \alpha_+ + \beta_+ (X_i - c) α + + β + ( X i − c ) :
カットオフ c c c 0 0 0 X i = c X_i = c X i = c β + ( c − c ) = 0 \beta_+ (c - c) = 0 β + ( c − c ) = 0 切片 α + \alpha_+ α + c c c μ + \mu_+ μ + ように設計されています。傾き β + \beta_+ β + 二乗残差 ( Y i − α + − β + ( X i − c ) ) 2 \left( Y_i - \alpha_+ - \beta_+ (X_i - c) \right)^2 ( Y i − α + − β + ( X i − c ) ) 2 :
実際のデータ Y i Y_i Y i カーネル重み k ( X i − c h ) k\left( \frac{X_i - c}{h} \right) k ( h X i − c ) :
ここがカーネル法の心臓部です。u = X i − c h u = \frac{X_i - c}{h} u = h X i − c h h h X i ≈ c X_i \approx c X i ≈ c u ≈ 0 u \approx 0 u ≈ 0 k ( u ) k(u) k ( u ) h h h 0 0 0
この最適化問題を解いて得られる切片の推定量 α ^ + \hat{\alpha}_+ α ^ + μ + \mu_+ μ + μ ^ + \hat{\mu}_+ μ ^ + X i < c X_i < c X i < c μ ^ − \hat{\mu}_- μ ^ −
τ ^ r d d = μ ^ + − μ ^ − (3.16) \hat{\tau}_{\mathrm{rdd}} = \hat{\mu}_+ - \hat{\mu}_- \tag{3.16} τ ^ rdd = μ ^ + − μ ^ − ( 3.16 ) 漸近展開の行間を埋める:バイアスと分散の数学的導出
文献(p.66)では、処置効果推定量 τ ^ r d d = μ ^ + − μ ^ − \hat{\tau}_{\mathrm{rdd}} = \hat{\mu}_+ - \hat{\mu}_- τ ^ rdd = μ ^ + − μ ^ −
E [ τ ^ r d d − τ r d d ∣ X ] ≈ h 2 2 κ 2 ∗ ( k ∗ ) ( μ ′ ′ ( c + ) − μ ′ ′ ( c − ) ) ≡ B ( h ) \mathbb{E}[\hat{\tau}_{\mathrm{rdd}} - \tau_{\mathrm{rdd}} \mid \mathbf{X}] \approx \frac{h^2}{2} \kappa_2^*(k^*) \left( \mu''(c_+) - \mu''(c_-) \right) \equiv B(h) E [ τ ^ rdd − τ rdd ∣ X ] ≈ 2 h 2 κ 2 ∗ ( k ∗ ) ( μ ′′ ( c + ) − μ ′′ ( c − ) ) ≡ B ( h ) V a r ( τ ^ r d d ∣ X ) = R ∗ ( k ∗ ) n h ( σ 2 ( c + ) f ( c + ) + σ 2 ( c − ) f ( c − ) ) + o p ( 1 n h ) ≡ V ( h ) \mathbb{V}\mathrm{ar}(\hat{\tau}_{\mathrm{rdd}} \mid \mathbf{X}) = \frac{R^*(k^*)}{nh} \left( \frac{\sigma^2(c_+)}{f(c_+)} + \frac{\sigma^2(c_-)}{f(c_-)} \right) + o_p\left(\frac{1}{nh}\right) \equiv V(h) V ar ( τ ^ rdd ∣ X ) = nh R ∗ ( k ∗ ) ( f ( c + ) σ 2 ( c + ) + f ( c − ) σ 2 ( c − ) ) + o p ( nh 1 ) ≡ V ( h ) これらの式は一見すると非常に難解ですが、「① 局所線形回帰を行列で解く」「② 等価カーネル(Equivalent Kernel)を定義する」「③ テイラー展開と置換積分を行う」 という標準的なステップで完全に導出できます。行間を省略せずにステップ・バイ・ステップで追っていきましょう。
ステップ1:局所線形推定量を行列で解く(正規方程式)
カットオフの右側(X i ≥ c X_i \ge c X i ≥ c n + n_+ n + α + \alpha_+ α + β + \beta_+ β +
min α + , β + ∑ i : X i ≥ c ( Y i − α + − β + ( X i − c ) ) 2 k ( X i − c h ) \min_{\alpha_+, \beta_+} \sum_{i: X_i \ge c} \left( Y_i - \alpha_+ - \beta_+ (X_i - c) \right)^2 k\left(\frac{X_i - c}{h}\right) α + , β + min i : X i ≥ c ∑ ( Y i − α + − β + ( X i − c ) ) 2 k ( h X i − c ) 各データ i i i z i ≡ ( 1 X i − c ) \mathbf{z}_i \equiv \begin{pmatrix} 1 \\ X_i - c \end{pmatrix} z i ≡ ( 1 X i − c ) z i ⊤ ( α + β + ) \mathbf{z}_i^\top \begin{pmatrix} \alpha_+ \\ \beta_+ \end{pmatrix} z i ⊤ ( α + β + ) α + \alpha_+ α + β + \beta_+ β + 0 0 0
∑ i : X i ≥ c z i ( Y i − z i ⊤ ( α ^ + β ^ + ) ) k ( X i − c h ) = 0 \sum_{i: X_i \ge c} \mathbf{z}_i \left( Y_i - \mathbf{z}_i^\top \begin{pmatrix} \hat{\alpha}_+ \\ \hat{\beta}_+ \end{pmatrix} \right) k\left(\frac{X_i - c}{h}\right) = \mathbf{0} i : X i ≥ c ∑ z i ( Y i − z i ⊤ ( α ^ + β ^ + ) ) k ( h X i − c ) = 0 式を整理して未知のパラメータベクトル ( α ^ + β ^ + ) \begin{pmatrix} \hat{\alpha}_+ \\ \hat{\beta}_+ \end{pmatrix} ( α ^ + β ^ + )
( ∑ i : X i ≥ c z i z i ⊤ k ( X i − c h ) ) ( α ^ + β ^ + ) = ∑ i : X i ≥ c z i Y i k ( X i − c h ) \left( \sum_{i: X_i \ge c} \mathbf{z}_i \mathbf{z}_i^\top k\left(\frac{X_i - c}{h}\right) \right) \begin{pmatrix} \hat{\alpha}_+ \\ \hat{\beta}_+ \end{pmatrix} = \sum_{i: X_i \ge c} \mathbf{z}_i Y_i k\left(\frac{X_i - c}{h}\right) ( i : X i ≥ c ∑ z i z i ⊤ k ( h X i − c ) ) ( α ^ + β ^ + ) = i : X i ≥ c ∑ z i Y i k ( h X i − c ) ここで、2 × 2 2 \times 2 2 × 2 S n , + \mathbf{S}_{n, +} S n , + z i z i ⊤ = ( 1 X i − c ) ( 1 X i − c ) = ( 1 X i − c X i − c ( X i − c ) 2 ) \mathbf{z}_i \mathbf{z}_i^\top = \begin{pmatrix} 1 \\ X_i - c \end{pmatrix} \begin{pmatrix} 1 & X_i - c \end{pmatrix} = \begin{pmatrix} 1 & X_i - c \\ X_i - c & (X_i - c)^2 \end{pmatrix} z i z i ⊤ = ( 1 X i − c ) ( 1 X i − c ) = ( 1 X i − c X i − c ( X i − c ) 2 )
S n , + ≡ ∑ i : X i ≥ c z i z i ⊤ k ( X i − c h ) = ( S n , 0 S n , 1 S n , 1 S n , 2 ) \mathbf{S}_{n, +} \equiv \sum_{i: X_i \ge c} \mathbf{z}_i \mathbf{z}_i^\top k\left(\frac{X_i - c}{h}\right) = \begin{pmatrix} S_{n, 0} & S_{n, 1} \\ S_{n, 1} & S_{n, 2} \end{pmatrix} S n , + ≡ i : X i ≥ c ∑ z i z i ⊤ k ( h X i − c ) = ( S n , 0 S n , 1 S n , 1 S n , 2 ) ただし、各要素 S n , j S_{n, j} S n , j j j j
S n , j ≡ ∑ i : X i ≥ c ( X i − c ) j k ( X i − c h ) ( j = 0 , 1 , 2 ) S_{n, j} \equiv \sum_{i: X_i \ge c} (X_i - c)^j k\left(\frac{X_i - c}{h}\right) \quad (j = 0, 1, 2) S n , j ≡ i : X i ≥ c ∑ ( X i − c ) j k ( h X i − c ) ( j = 0 , 1 , 2 ) 両辺に左から逆行列 S n , + − 1 \mathbf{S}_{n, +}^{-1} S n , + − 1
( α ^ + β ^ + ) = S n , + − 1 ∑ i : X i ≥ c z i Y i k ( X i − c h ) \begin{pmatrix} \hat{\alpha}_+ \\ \hat{\beta}_+ \end{pmatrix} = \mathbf{S}_{n, +}^{-1} \sum_{i: X_i \ge c} \mathbf{z}_i Y_i k\left(\frac{X_i - c}{h}\right) ( α ^ + β ^ + ) = S n , + − 1 i : X i ≥ c ∑ z i Y i k ( h X i − c ) ステップ1.5:2 × 2 2 \times 2 2 × 2 α ^ + \hat{\alpha}_+ α ^ +
「ここが教科書で一番省略されがちな最大の行間です!」
私たちが知りたいのは境界上の極限値(切片 μ ^ + = α ^ + \hat{\mu}_+ = \hat{\alpha}_+ μ ^ + = α ^ + β ^ + \hat{\beta}_+ β ^ +
まず、2 × 2 2 \times 2 2 × 2 ( a b c d ) − 1 = 1 a d − b c ( d − b − c a ) \begin{pmatrix} a & b \\ c & d \end{pmatrix}^{-1} = \frac{1}{ad - bc} \begin{pmatrix} d & -b \\ -c & a \end{pmatrix} ( a c b d ) − 1 = a d − b c 1 ( d − c − b a ) S n , + \mathbf{S}_{n, +} S n , +
S n , + − 1 = 1 S n , 0 S n , 2 − S n , 1 2 ( S n , 2 − S n , 1 − S n , 1 S n , 0 ) \mathbf{S}_{n, +}^{-1} = \frac{1}{S_{n, 0} S_{n, 2} - S_{n, 1}^2} \begin{pmatrix} S_{n, 2} & -S_{n, 1} \\ -S_{n, 1} & S_{n, 0} \end{pmatrix} S n , + − 1 = S n , 0 S n , 2 − S n , 1 2 1 ( S n , 2 − S n , 1 − S n , 1 S n , 0 ) 第1行目の切片 α ^ + \hat{\alpha}_+ α ^ + e 1 ⊤ = ( 1 0 ) \mathbf{e}_1^\top = \begin{pmatrix} 1 & 0 \end{pmatrix} e 1 ⊤ = ( 1 0 )
α ^ + = ( 1 0 ) ( α ^ + β ^ + ) = ( 1 0 ) S n , + − 1 ∑ i : X i ≥ c z i Y i k ( X i − c h ) \hat{\alpha}_+ = \begin{pmatrix} 1 & 0 \end{pmatrix} \begin{pmatrix} \hat{\alpha}_+ \\ \hat{\beta}_+ \end{pmatrix} = \begin{pmatrix} 1 & 0 \end{pmatrix} \mathbf{S}_{n, +}^{-1} \sum_{i: X_i \ge c} \mathbf{z}_i Y_i k\left(\frac{X_i - c}{h}\right) α ^ + = ( 1 0 ) ( α ^ + β ^ + ) = ( 1 0 ) S n , + − 1 i : X i ≥ c ∑ z i Y i k ( h X i − c ) ここで、前半の行列積を計算してみましょう:
( 1 0 ) ( S n , 2 − S n , 1 − S n , 1 S n , 0 ) = ( S n , 2 − S n , 1 ) \begin{pmatrix} 1 & 0 \end{pmatrix} \begin{pmatrix} S_{n, 2} & -S_{n, 1} \\ -S_{n, 1} & S_{n, 0} \end{pmatrix} = \begin{pmatrix} S_{n, 2} & -S_{n, 1} \end{pmatrix} ( 1 0 ) ( S n , 2 − S n , 1 − S n , 1 S n , 0 ) = ( S n , 2 − S n , 1 ) これと後ろにある設計ベクトル z i = ( 1 X i − c ) \mathbf{z}_i = \begin{pmatrix} 1 \\ X_i - c \end{pmatrix} z i = ( 1 X i − c )
( S n , 2 − S n , 1 ) ( 1 X i − c ) = S n , 2 − S n , 1 ( X i − c ) \begin{pmatrix} S_{n, 2} & -S_{n, 1} \end{pmatrix} \begin{pmatrix} 1 \\ X_i - c \end{pmatrix} = S_{n, 2} - S_{n, 1} (X_i - c) ( S n , 2 − S n , 1 ) ( 1 X i − c ) = S n , 2 − S n , 1 ( X i − c ) なんと、分子に S n , 2 − S n , 1 ( X i − c ) S_{n, 2} - S_{n, 1}(X_i - c) S n , 2 − S n , 1 ( X i − c ) α ^ + \hat{\alpha}_+ α ^ + Y i Y_i Y i
α ^ + = ∑ i : X i ≥ c [ S n , 2 − S n , 1 ( X i − c ) S n , 0 S n , 2 − S n , 1 2 ] k ( X i − c h ) Y i \hat{\alpha}_+ = \sum_{i: X_i \ge c} \left[ \frac{S_{n, 2} - S_{n, 1} (X_i - c)}{S_{n, 0} S_{n, 2} - S_{n, 1}^2} \right] k\left(\frac{X_i - c}{h}\right) Y_i α ^ + = i : X i ≥ c ∑ [ S n , 0 S n , 2 − S n , 1 2 S n , 2 − S n , 1 ( X i − c ) ] k ( h X i − c ) Y i この分子の「S n , 2 − S n , 1 ( X i − c ) S_{n, 2} - S_{n, 1}(X_i - c) S n , 2 − S n , 1 ( X i − c ) S n , 0 S n , 2 − S n , 1 2 S_{n, 0} S_{n, 2} - S_{n, 1}^2 S n , 0 S n , 2 − S n , 1 2
ステップ2:大数の法則と置換積分による「等価カーネル」k ∗ ( u ) k^*(u) k ∗ ( u )
標本和 S n , j S_{n, j} S n , j n → ∞ n \to \infty n → ∞ X X X f ( x ) f(x) f ( x )
S n , j = ∑ i : X i ≥ c ( X i − c ) j k ( X i − c h ) ≈ n ∫ c ∞ ( x − c ) j k ( x − c h ) f ( x ) d x S_{n, j} = \sum_{i: X_i \ge c} (X_i - c)^j k\left(\frac{X_i - c}{h}\right) \approx n \int_c^\infty (x - c)^j k\left(\frac{x - c}{h}\right) f(x) \, dx S n , j = i : X i ≥ c ∑ ( X i − c ) j k ( h X i − c ) ≈ n ∫ c ∞ ( x − c ) j k ( h x − c ) f ( x ) d x ここで、変数変換(置換積分) u = x − c h ⟺ x − c = h u , d x = h d u u = \frac{x - c}{h} \iff x - c = hu, \, dx = h \, du u = h x − c ⟺ x − c = h u , d x = h d u
※ ここが RDD における最大の数理的急所です :( − ∞ , ∞ ) (-\infty, \infty) ( − ∞ , ∞ ) x ≥ c x \ge c x ≥ c [ 0 , ∞ ) [0, \infty) [ 0 , ∞ )
バンド幅 h → 0 h \to 0 h → 0 f ( c + h u ) ≈ f ( c + ) f(c + hu) \approx f(c_+) f ( c + h u ) ≈ f ( c + )
S n , j ≈ n ∫ 0 ∞ ( h u ) j k ( u ) f ( c + ) ⋅ h d u = n h j + 1 f ( c + ) ∫ 0 ∞ u j k ( u ) d u S_{n, j} \approx n \int_0^\infty (hu)^j k(u) f(c_+) \cdot h \, du = n h^{j+1} f(c_+) \int_0^\infty u^j k(u) \, du S n , j ≈ n ∫ 0 ∞ ( h u ) j k ( u ) f ( c + ) ⋅ h d u = n h j + 1 f ( c + ) ∫ 0 ∞ u j k ( u ) d u ここで、カーネルの「片側 j j j ν j ≡ ∫ 0 ∞ u j k ( u ) d u \nu_j \equiv \int_0^\infty u^j k(u) \, du ν j ≡ ∫ 0 ∞ u j k ( u ) d u
S n , 0 ≈ n h f ( c + ) ν 0 S_{n, 0} \approx n h f(c_+) \nu_0 S n , 0 ≈ nh f ( c + ) ν 0 S n , 1 ≈ n h 2 f ( c + ) ν 1 S_{n, 1} \approx n h^2 f(c_+) \nu_1 S n , 1 ≈ n h 2 f ( c + ) ν 1 S n , 2 ≈ n h 3 f ( c + ) ν 2 S_{n, 2} \approx n h^3 f(c_+) \nu_2 S n , 2 ≈ n h 3 f ( c + ) ν 2 これを先ほどステップ1.5で導出した α ^ + \hat{\alpha}_+ α ^ + X i − c = h u i X_i - c = h u_i X i − c = h u i
【分子の計算】
S n , 2 − S n , 1 ( X i − c ) ≈ n h 3 f ( c + ) ν 2 − ( n h 2 f ( c + ) ν 1 ) ⋅ ( h u i ) = n h 3 f ( c + ) ( ν 2 − ν 1 u i ) S_{n, 2} - S_{n, 1} (X_i - c) \approx n h^3 f(c_+) \nu_2 - \left( n h^2 f(c_+) \nu_1 \right) \cdot (h u_i) = n h^3 f(c_+) (\nu_2 - \nu_1 u_i) S n , 2 − S n , 1 ( X i − c ) ≈ n h 3 f ( c + ) ν 2 − ( n h 2 f ( c + ) ν 1 ) ⋅ ( h u i ) = n h 3 f ( c + ) ( ν 2 − ν 1 u i ) 【分母の計算】
S n , 0 S n , 2 − S n , 1 2 ≈ ( n h f ( c + ) ν 0 ) ( n h 3 f ( c + ) ν 2 ) − ( n h 2 f ( c + ) ν 1 ) 2 = [ n h 2 f ( c + ) ] 2 ( ν 0 ν 2 − ν 1 2 ) S_{n, 0} S_{n, 2} - S_{n, 1}^2 \approx (n h f(c_+) \nu_0)(n h^3 f(c_+) \nu_2) - (n h^2 f(c_+) \nu_1)^2 = [n h^2 f(c_+)]^2 (\nu_0 \nu_2 - \nu_1^2) S n , 0 S n , 2 − S n , 1 2 ≈ ( nh f ( c + ) ν 0 ) ( n h 3 f ( c + ) ν 2 ) − ( n h 2 f ( c + ) ν 1 ) 2 = [ n h 2 f ( c + ) ] 2 ( ν 0 ν 2 − ν 1 2 ) 【分子を分母で割る】
S n , 2 − S n , 1 ( X i − c ) S n , 0 S n , 2 − S n , 1 2 ≈ n h 3 f ( c + ) ( ν 2 − ν 1 u i ) n 2 h 4 f ( c + ) 2 ( ν 0 ν 2 − ν 1 2 ) = 1 n h f ( c + ) [ ν 2 − ν 1 u i ν 0 ν 2 − ν 1 2 ] \frac{S_{n, 2} - S_{n, 1} (X_i - c)}{S_{n, 0} S_{n, 2} - S_{n, 1}^2} \approx \frac{n h^3 f(c_+) (\nu_2 - \nu_1 u_i)}{n^2 h^4 f(c_+)^2 (\nu_0 \nu_2 - \nu_1^2)} = \frac{1}{n h f(c_+)} \left[ \frac{\nu_2 - \nu_1 u_i}{\nu_0 \nu_2 - \nu_1^2} \right] S n , 0 S n , 2 − S n , 1 2 S n , 2 − S n , 1 ( X i − c ) ≈ n 2 h 4 f ( c + ) 2 ( ν 0 ν 2 − ν 1 2 ) n h 3 f ( c + ) ( ν 2 − ν 1 u i ) = nh f ( c + ) 1 [ ν 0 ν 2 − ν 1 2 ν 2 − ν 1 u i ] 驚くべきことに、h h h n f ( c + ) n f(c_+) n f ( c + ) α ^ + \hat{\alpha}_+ α ^ +
μ ^ + = α ^ + = 1 n h f ( c + ) ∑ i : X i ≥ c [ ν 2 − ν 1 u i ν 0 ν 2 − ν 1 2 k ( u i ) ] ⏟ k ∗ ( u i ) Y i + o p ( 1 n h ) \hat{\mu}_+ = \hat{\alpha}_+ = \frac{1}{n h f(c_+)} \sum_{i: X_i \ge c} \underbrace{\left[ \frac{\nu_2 - \nu_1 u_i}{\nu_0 \nu_2 - \nu_1^2} k(u_i) \right]}_{k^*(u_i)} Y_i + o_p\left(\frac{1}{\sqrt{nh}}\right) μ ^ + = α ^ + = nh f ( c + ) 1 i : X i ≥ c ∑ k ∗ ( u i ) [ ν 0 ν 2 − ν 1 2 ν 2 − ν 1 u i k ( u i ) ] Y i + o p ( nh 1 ) これこそが、文献(p.66 式(3.12))に突如として登場する「等価カーネル(Equivalent Kernel / 境界カーネル)」k ∗ ( u ) k^*(u) k ∗ ( u ) です:
k ∗ ( u ) ≡ ν 2 − ν 1 u ν 0 ν 2 − ν 1 2 k ( u ) (3.12) k^*(u) \equiv \frac{\nu_2 - \nu_1 u}{\nu_0 \nu_2 - \nu_1^2} k(u) \tag{3.12} k ∗ ( u ) ≡ ν 0 ν 2 − ν 1 2 ν 2 − ν 1 u k ( u ) ( 3.12 ) この等価カーネル k ∗ ( u ) k^*(u) k ∗ ( u )
1. 0次モーメント(定数の一致性)
∫ 0 ∞ k ∗ ( u ) d u = 1 \int_0^\infty k^*(u) \, du = 1 ∫ 0 ∞ k ∗ ( u ) d u = 1 2. 1次モーメント(傾きバイアスの完全消去!)
∫ 0 ∞ u k ∗ ( u ) d u = 0 \int_0^\infty u k^*(u) \, du = 0 ∫ 0 ∞ u k ∗ ( u ) d u = 0 3. 2次モーメント(曲率定数・式(3.13))
κ 2 ∗ ( k ∗ ) ≡ ∫ 0 ∞ u 2 k ∗ ( u ) d u > 0 (3.13) \kappa_2^*(k^*) \equiv \int_0^\infty u^2 k^*(u) \, du > 0 \tag{3.13} κ 2 ∗ ( k ∗ ) ≡ ∫ 0 ∞ u 2 k ∗ ( u ) d u > 0 ( 3.13 ) ステップ3:バイアス B ( h ) B(h) B ( h )
まずはステップ2で導出した等価カーネルによる切片推定量 μ ^ + \hat{\mu}_+ μ ^ + を振り返りましょう:
μ ^ + = 1 n h f ( c + ) ∑ i : X i ≥ c k ∗ ( X i − c h ) Y i + o p ( 1 n h ) \hat{\mu}_+ = \frac{1}{n h f(c_+)} \sum_{i: X_i \ge c} k^*\left(\frac{X_i - c}{h}\right) Y_i + o_p\left(\frac{1}{\sqrt{nh}}\right) μ ^ + = nh f ( c + ) 1 i : X i ≥ c ∑ k ∗ ( h X i − c ) Y i + o p ( nh 1 ) ここに真のデータ生成モデル Y i = μ ( X i ) + ε i Y_i = \mu(X_i) + \varepsilon_i Y i = μ ( X i ) + ε i E [ ε i ∣ X ] = 0 \mathbb{E}[\varepsilon_i \mid \mathbf{X}] = 0 E [ ε i ∣ X ] = 0 E [ Y i ∣ X ] = μ ( X i ) \mathbb{E}[Y_i \mid \mathbf{X}] = \mu(X_i) E [ Y i ∣ X ] = μ ( X i )
E [ μ ^ + ∣ X ] ≈ 1 n h f ( c + ) ∑ i : X i ≥ c k ∗ ( X i − c h ) μ ( X i ) \mathbb{E}[\hat{\mu}_+ \mid \mathbf{X}] \approx \frac{1}{n h f(c_+)} \sum_{i: X_i \ge c} k^*\left(\frac{X_i - c}{h}\right) \mu(X_i) E [ μ ^ + ∣ X ] ≈ nh f ( c + ) 1 i : X i ≥ c ∑ k ∗ ( h X i − c ) μ ( X i ) ここで、未知の回帰関数 μ ( X i ) \mu(X_i) μ ( X i ) x = c x = c x = c
μ ( X i ) = μ ( c + ) + μ ′ ( c + ) ( X i − c ) + 1 2 μ ′ ′ ( c + ) ( X i − c ) 2 + o ( ( X i − c ) 2 ) \mu(X_i) = \mu(c_+) + \mu'(c_+)(X_i - c) + \frac{1}{2} \mu''(c_+)(X_i - c)^2 + o((X_i - c)^2) μ ( X i ) = μ ( c + ) + μ ′ ( c + ) ( X i − c ) + 2 1 μ ′′ ( c + ) ( X i − c ) 2 + o (( X i − c ) 2 ) この展開式を上の期待値の式に代入すると、期待値は「定数項」「1階微分(傾き)の項」「2階微分(曲率)の項」の3つに分解されます:
E [ μ ^ + ∣ X ] ≈ μ ( c + ) ⋅ [ 1 n h f ( c + ) ∑ i : X i ≥ c k ∗ ( X i − c h ) ] ⏟ 第0項(定数項) + μ ′ ( c + ) ⋅ [ 1 n h f ( c + ) ∑ i : X i ≥ c ( X i − c ) k ∗ ( X i − c h ) ] ⏟ 第1項(傾きの項) + 1 2 μ ′ ′ ( c + ) ⋅ [ 1 n h f ( c + ) ∑ i : X i ≥ c ( X i − c ) 2 k ∗ ( X i − c h ) ] ⏟ 第2項(曲率の項) + o p ( h 2 ) \begin{aligned}
\mathbb{E}[\hat{\mu}_+ \mid \mathbf{X}] &\approx \mu(c_+) \cdot \underbrace{\left[ \frac{1}{n h f(c_+)} \sum_{i: X_i \ge c} k^*\left(\frac{X_i - c}{h}\right) \right]}_{\text{第0項(定数項)}} \\
&+ \mu'(c_+) \cdot \underbrace{\left[ \frac{1}{n h f(c_+)} \sum_{i: X_i \ge c} (X_i - c) k^*\left(\frac{X_i - c}{h}\right) \right]}_{\text{第1項(傾きの項)}} \\
&+ \frac{1}{2} \mu''(c_+) \cdot \underbrace{\left[ \frac{1}{n h f(c_+)} \sum_{i: X_i \ge c} (X_i - c)^2 k^*\left(\frac{X_i - c}{h}\right) \right]}_{\text{第2項(曲率の項)}} + o_p(h^2)
\end{aligned} E [ μ ^ + ∣ X ] ≈ μ ( c + ) ⋅ 第 0 項(定数項) [ nh f ( c + ) 1 i : X i ≥ c ∑ k ∗ ( h X i − c ) ] + μ ′ ( c + ) ⋅ 第 1 項(傾きの項) [ nh f ( c + ) 1 i : X i ≥ c ∑ ( X i − c ) k ∗ ( h X i − c ) ] + 2 1 μ ′′ ( c + ) ⋅ 第 2 項(曲率の項) [ nh f ( c + ) 1 i : X i ≥ c ∑ ( X i − c ) 2 k ∗ ( h X i − c ) ] + o p ( h 2 ) 大数の法則により標本平均 1 n ∑ i : X i ≥ c ( ⋅ ) \frac{1}{n}\sum_{i: X_i \ge c} (\cdot) n 1 ∑ i : X i ≥ c ( ⋅ ) ∫ c ∞ ( ⋅ ) f ( x ) d x \int_c^\infty (\cdot) f(x) \, dx ∫ c ∞ ( ⋅ ) f ( x ) d x f ( x ) ≈ f ( c + ) f(x) \approx f(c_+) f ( x ) ≈ f ( c + ) u = x − c h ⟺ x − c = h u u = \frac{x - c}{h} \iff x - c = hu u = h x − c ⟺ x − c = h u d x = h d u dx = h \, du d x = h d u h f ( c + ) h f(c_+) h f ( c + ) h f ( c + ) h f(c_+) h f ( c + )
第0項(定数項) :
1 h f ( c + ) ∫ c ∞ k ∗ ( x − c h ) f ( x ) d x ≈ f ( c + ) h f ( c + ) ∫ 0 ∞ k ∗ ( u ) ⋅ ( h d u ) = ∫ 0 ∞ k ∗ ( u ) d u = 1 \frac{1}{h f(c_+)} \int_c^\infty k^*\left(\frac{x - c}{h}\right) f(x) \, dx \approx \frac{f(c_+)}{h f(c_+)} \int_0^\infty k^*(u) \cdot (h \, du) = \int_0^\infty k^*(u) \, du = 1 h f ( c + ) 1 ∫ c ∞ k ∗ ( h x − c ) f ( x ) d x ≈ h f ( c + ) f ( c + ) ∫ 0 ∞ k ∗ ( u ) ⋅ ( h d u ) = ∫ 0 ∞ k ∗ ( u ) d u = 1 (等価カーネルの0次モーメント条件により 1 1 1 μ ( c + ) \mu(c_+) μ ( c + )
第1項(傾きの項) :X i − c = h u X_i - c = hu X i − c = h u h h h
1 h f ( c + ) ∫ c ∞ ( x − c ) k ∗ ( x − c h ) f ( x ) d x ≈ f ( c + ) h f ( c + ) ∫ 0 ∞ ( h u ) k ∗ ( u ) ⋅ ( h d u ) = h ∫ 0 ∞ u k ∗ ( u ) d u ⏟ = 0 = 0 \frac{1}{h f(c_+)} \int_c^\infty (x - c) k^*\left(\frac{x - c}{h}\right) f(x) \, dx \approx \frac{f(c_+)}{h f(c_+)} \int_0^\infty (hu) k^*(u) \cdot (h \, du) = h \underbrace{\int_0^\infty u k^*(u) \, du}_{= 0} = 0 h f ( c + ) 1 ∫ c ∞ ( x − c ) k ∗ ( h x − c ) f ( x ) d x ≈ h f ( c + ) f ( c + ) ∫ 0 ∞ ( h u ) k ∗ ( u ) ⋅ ( h d u ) = h = 0 ∫ 0 ∞ u k ∗ ( u ) d u = 0 (等価カーネルの1次モーメント直交条件により、傾きによるバイアスが自動的に完全消去 されます!)
第2項(曲率の項) :( X i − c ) 2 = h 2 u 2 (X_i - c)^2 = h^2 u^2 ( X i − c ) 2 = h 2 u 2 h 2 h^2 h 2
1 h f ( c + ) ∫ c ∞ ( x − c ) 2 k ∗ ( x − c h ) f ( x ) d x ≈ f ( c + ) h f ( c + ) ∫ 0 ∞ ( h 2 u 2 ) k ∗ ( u ) ⋅ ( h d u ) = h 2 ∫ 0 ∞ u 2 k ∗ ( u ) d u ⏟ = κ 2 ∗ ( k ∗ ) = h 2 κ 2 ∗ ( k ∗ ) \frac{1}{h f(c_+)} \int_c^\infty (x - c)^2 k^*\left(\frac{x - c}{h}\right) f(x) \, dx \approx \frac{f(c_+)}{h f(c_+)} \int_0^\infty (h^2 u^2) k^*(u) \cdot (h \, du) = h^2 \underbrace{\int_0^\infty u^2 k^*(u) \, du}_{= \kappa_2^*(k^*)} = h^2 \kappa_2^*(k^*) h f ( c + ) 1 ∫ c ∞ ( x − c ) 2 k ∗ ( h x − c ) f ( x ) d x ≈ h f ( c + ) f ( c + ) ∫ 0 ∞ ( h 2 u 2 ) k ∗ ( u ) ⋅ ( h d u ) = h 2 = κ 2 ∗ ( k ∗ ) ∫ 0 ∞ u 2 k ∗ ( u ) d u = h 2 κ 2 ∗ ( k ∗ )
これらをまとめると、求める右側切片の漸近期待値が得られます:
E [ μ ^ + ∣ X ] = μ ( c + ) ⋅ 1 + μ ′ ( c + ) ⋅ 0 + h 2 2 μ ′ ′ ( c + ) κ 2 ∗ ( k ∗ ) + o p ( h 2 ) = μ ( c + ) + h 2 2 κ 2 ∗ ( k ∗ ) μ ′ ′ ( c + ) + o p ( h 2 ) \mathbb{E}[\hat{\mu}_+ \mid \mathbf{X}] = \mu(c_+) \cdot 1 + \mu'(c_+) \cdot 0 + \frac{h^2}{2} \mu''(c_+) \kappa_2^*(k^*) + o_p(h^2) = \mu(c_+) + \frac{h^2}{2} \kappa_2^*(k^*) \mu''(c_+) + o_p(h^2) E [ μ ^ + ∣ X ] = μ ( c + ) ⋅ 1 + μ ′ ( c + ) ⋅ 0 + 2 h 2 μ ′′ ( c + ) κ 2 ∗ ( k ∗ ) + o p ( h 2 ) = μ ( c + ) + 2 h 2 κ 2 ∗ ( k ∗ ) μ ′′ ( c + ) + o p ( h 2 ) 左側の推定量 μ ^ − \hat{\mu}_- μ ^ − u = ( c − x ) / h u = (c - x)/h u = ( c − x ) / h
E [ μ ^ − ∣ X ] = μ ( c − ) + h 2 2 κ 2 ∗ ( k ∗ ) μ ′ ′ ( c − ) + o p ( h 2 ) \mathbb{E}[\hat{\mu}_- \mid \mathbf{X}] = \mu(c_-) + \frac{h^2}{2} \kappa_2^*(k^*) \mu''(c_-) + o_p(h^2) E [ μ ^ − ∣ X ] = μ ( c − ) + 2 h 2 κ 2 ∗ ( k ∗ ) μ ′′ ( c − ) + o p ( h 2 ) この2つの期待値の差を取ると、真の局所処置効果 τ r d d = μ ( c + ) − μ ( c − ) \tau_{\mathrm{rdd}} = \mu(c_+) - \mu(c_-) τ rdd = μ ( c + ) − μ ( c − ) B ( h ) B(h) B ( h ) τ r d d \tau_{\mathrm{rdd}} τ rdd
E [ τ ^ r d d − τ r d d ∣ X ] = E [ τ ^ r d d ∣ X ] − τ r d d = h 2 2 κ 2 ∗ ( k ∗ ) ( μ ′ ′ ( c + ) − μ ′ ′ ( c − ) ) + o p ( h 2 ) ≡ B ( h ) \mathbb{E}[\hat{\tau}_{\mathrm{rdd}} - \tau_{\mathrm{rdd}} \mid \mathbf{X}] = \mathbb{E}[\hat{\tau}_{\mathrm{rdd}} \mid \mathbf{X}] - \tau_{\mathrm{rdd}} = \frac{h^2}{2} \kappa_2^*(k^*) \left( \mu''(c_+) - \mu''(c_-) \right) + o_p(h^2) \equiv B(h) E [ τ ^ rdd − τ rdd ∣ X ] = E [ τ ^ rdd ∣ X ] − τ rdd = 2 h 2 κ 2 ∗ ( k ∗ ) ( μ ′′ ( c + ) − μ ′′ ( c − ) ) + o p ( h 2 ) ≡ B ( h ) 【数理的結論】 :
局所線形 回帰(LL)を使ったことで、1階微分(傾き μ ′ \mu' μ ′ ∫ 0 ∞ u k ∗ ( u ) d u = 0 \int_0^\infty u k^*(u) \, du = 0 ∫ 0 ∞ u k ∗ ( u ) d u = 0 跡形もなく消滅 しました。
残るバイアスは、直線では曲がりを吸収できない「2階微分(曲率 μ ′ ′ \mu'' μ ′′ h 2 h^2 h 2
ステップ4:分散 V ( h ) V(h) V ( h )
次に推定量 μ ^ + \hat{\mu}_+ μ ^ +
【なぜ w i Y i w_i Y_i w i Y i
ステップ2で求めた等価カーネルによる切片推定量 μ ^ + \hat{\mu}_+ μ ^ +
μ ^ + = 1 n h f ( c + ) ∑ i : X i ≥ c k ∗ ( X i − c h ) Y i + o p ( 1 n h ) \hat{\mu}_+ = \frac{1}{n h f(c_+)} \sum_{i: X_i \ge c} k^*\left(\frac{X_i - c}{h}\right) Y_i + o_p\left(\frac{1}{\sqrt{nh}}\right) μ ^ + = nh f ( c + ) 1 i : X i ≥ c ∑ k ∗ ( h X i − c ) Y i + o p ( nh 1 ) ここで、目的変数 Y i Y_i Y i X i X_i X i w i w_i w i
w i ≡ 1 n h f ( c + ) k ∗ ( X i − c h ) w_i \equiv \frac{1}{n h f(c_+)} k^*\left(\frac{X_i - c}{h}\right) w i ≡ nh f ( c + ) 1 k ∗ ( h X i − c ) すると、主要項は μ ^ + ≈ ∑ i : X i ≥ c w i Y i \hat{\mu}_+ \approx \sum_{i: X_i \ge c} w_i Y_i μ ^ + ≈ ∑ i : X i ≥ c w i Y i 各サンプルの観測値 Y i Y_i Y i としてシンプルに表せます。このように局所線形回帰推定量は、観測値 Y i Y_i Y i
【条件付分散の計算:なぜ w i 2 w_i^2 w i 2
共変量ベクトル X = ( X 1 , … , X n ) \mathbf{X} = (X_1, \dots, X_n) X = ( X 1 , … , X n ) w i w_i w i X i X_i X i 定数 として扱えます。
各個体の誤差項 ε i \varepsilon_i ε i V a r ( Y i ∣ X i = x ) = σ 2 ( x ) \mathbb{V}\mathrm{ar}(Y_i \mid X_i = x) = \sigma^2(x) V ar ( Y i ∣ X i = x ) = σ 2 ( x ) Cov ( Y i , Y j ∣ X ) = 0 ( i ≠ j ) \operatorname{Cov}(Y_i, Y_j \mid \mathbf{X}) = 0 \quad (i \ne j) Cov ( Y i , Y j ∣ X ) = 0 ( i = j )
定数 a i a_i a i Z i Z_i Z i V a r ( ∑ a i Z i ) = ∑ a i 2 V a r ( Z i ) \mathbb{V}\mathrm{ar}\left(\sum a_i Z_i\right) = \sum a_i^2 \mathbb{V}\mathrm{ar}(Z_i) V ar ( ∑ a i Z i ) = ∑ a i 2 V ar ( Z i ) w i 2 w_i^2 w i 2
V a r ( μ ^ + ∣ X ) ≈ V a r ( ∑ i : X i ≥ c w i Y i | X ) = ∑ i : X i ≥ c w i 2 V a r ( Y i ∣ X i ) \mathbb{V}\mathrm{ar}(\hat{\mu}_+ \mid \mathbf{X}) \approx \mathbb{V}\mathrm{ar}\left( \sum_{i: X_i \ge c} w_i Y_i \;\middle|\; \mathbf{X} \right) = \sum_{i: X_i \ge c} w_i^2 \mathbb{V}\mathrm{ar}(Y_i \mid X_i) V ar ( μ ^ + ∣ X ) ≈ V ar ( i : X i ≥ c ∑ w i Y i X ) = i : X i ≥ c ∑ w i 2 V ar ( Y i ∣ X i ) ここに w i = 1 n h f ( c + ) k ∗ ( X i − c h ) w_i = \frac{1}{n h f(c_+)} k^*\left(\frac{X_i - c}{h}\right) w i = nh f ( c + ) 1 k ∗ ( h X i − c )
V a r ( μ ^ + ∣ X ) ≈ ∑ i : X i ≥ c ( 1 n h f ( c + ) k ∗ ( X i − c h ) ) 2 σ 2 ( X i ) = 1 n 2 h 2 f ( c + ) 2 ∑ i : X i ≥ c ( k ∗ ( X i − c h ) ) 2 σ 2 ( X i ) \begin{aligned}
\mathbb{V}\mathrm{ar}(\hat{\mu}_+ \mid \mathbf{X}) &\approx \sum_{i: X_i \ge c} \left( \frac{1}{n h f(c_+)} k^*\left(\frac{X_i - c}{h}\right) \right)^2 \sigma^2(X_i) \\
&= \frac{1}{n^2 h^2 f(c_+)^2} \sum_{i: X_i \ge c} \left( k^*\left(\frac{X_i - c}{h}\right) \right)^2 \sigma^2(X_i)
\end{aligned} V ar ( μ ^ + ∣ X ) ≈ i : X i ≥ c ∑ ( nh f ( c + ) 1 k ∗ ( h X i − c ) ) 2 σ 2 ( X i ) = n 2 h 2 f ( c + ) 2 1 i : X i ≥ c ∑ ( k ∗ ( h X i − c ) ) 2 σ 2 ( X i ) 大数の法則により、標本和を積分に置き換えます(x = c + h u , d x = h d u x = c + hu, \, dx = h \, du x = c + h u , d x = h d u
∑ i : X i ≥ c ( k ∗ ( X i − c h ) ) 2 σ 2 ( X i ) ≈ n ∫ c ∞ ( k ∗ ( x − c h ) ) 2 σ 2 ( x ) f ( x ) d x = n ∫ 0 ∞ ( k ∗ ( u ) ) 2 ⋅ σ 2 ( c + ) f ( c + ) ⋅ h d u = n h σ 2 ( c + ) f ( c + ) ∫ 0 ∞ ( k ∗ ( u ) ) 2 d u ⏟ ≡ R ∗ ( k ∗ ) \begin{aligned}
\sum_{i: X_i \ge c} \left( k^*\left(\frac{X_i - c}{h}\right) \right)^2 \sigma^2(X_i) &\approx n \int_c^\infty \left( k^*\left(\frac{x - c}{h}\right) \right)^2 \sigma^2(x) f(x) \, dx \\
&= n \int_0^\infty (k^*(u))^2 \cdot \sigma^2(c_+) f(c_+) \cdot h \, du \\
&= n h \sigma^2(c_+) f(c_+) \underbrace{\int_0^\infty (k^*(u))^2 \, du}_{\equiv R^*(k^*)}
\end{aligned} i : X i ≥ c ∑ ( k ∗ ( h X i − c ) ) 2 σ 2 ( X i ) ≈ n ∫ c ∞ ( k ∗ ( h x − c ) ) 2 σ 2 ( x ) f ( x ) d x = n ∫ 0 ∞ ( k ∗ ( u ) ) 2 ⋅ σ 2 ( c + ) f ( c + ) ⋅ h d u = nh σ 2 ( c + ) f ( c + ) ≡ R ∗ ( k ∗ ) ∫ 0 ∞ ( k ∗ ( u ) ) 2 d u これを元の分散の式に代入すると、分子の n h n h nh n 2 h 2 n^2 h^2 n 2 h 2 f ( c + ) f(c_+) f ( c + )
V a r ( μ ^ + ∣ X ) ≈ n h σ 2 ( c + ) f ( c + ) R ∗ ( k ∗ ) n 2 h 2 f ( c + ) 2 = R ∗ ( k ∗ ) n h σ 2 ( c + ) f ( c + ) + o p ( 1 n h ) \mathbb{V}\mathrm{ar}(\hat{\mu}_+ \mid \mathbf{X}) \approx \frac{n h \sigma^2(c_+) f(c_+) R^*(k^*)}{n^2 h^2 f(c_+)^2} = \frac{R^*(k^*)}{nh} \frac{\sigma^2(c_+)}{f(c_+)} + o_p\left(\frac{1}{nh}\right) V ar ( μ ^ + ∣ X ) ≈ n 2 h 2 f ( c + ) 2 nh σ 2 ( c + ) f ( c + ) R ∗ ( k ∗ ) = nh R ∗ ( k ∗ ) f ( c + ) σ 2 ( c + ) + o p ( nh 1 ) カットオフの右側標本(X i ≥ c X_i \ge c X i ≥ c X i < c X_i < c X i < c Cov ( μ ^ + , μ ^ − ∣ X ) = 0 \operatorname{Cov}(\hat{\mu}_+, \hat{\mu}_- \mid \mathbf{X}) = 0 Cov ( μ ^ + , μ ^ − ∣ X ) = 0 τ ^ r d d = μ ^ + − μ ^ − \hat{\tau}_{\mathrm{rdd}} = \hat{\mu}_+ - \hat{\mu}_- τ ^ rdd = μ ^ + − μ ^ −
V a r ( τ ^ r d d ∣ X ) = V a r ( μ ^ + ∣ X ) + V a r ( μ ^ − ∣ X ) = R ∗ ( k ∗ ) n h ( σ 2 ( c + ) f ( c + ) + σ 2 ( c − ) f ( c − ) ) + o p ( 1 n h ) ≡ V ( h ) \mathbb{V}\mathrm{ar}(\hat{\tau}_{\mathrm{rdd}} \mid \mathbf{X}) = \mathbb{V}\mathrm{ar}(\hat{\mu}_+ \mid \mathbf{X}) + \mathbb{V}\mathrm{ar}(\hat{\mu}_- \mid \mathbf{X}) = \frac{R^*(k^*)}{nh} \left( \frac{\sigma^2(c_+)}{f(c_+)} + \frac{\sigma^2(c_-)}{f(c_-)} \right) + o_p\left(\frac{1}{nh}\right) \equiv V(h) V ar ( τ ^ rdd ∣ X ) = V ar ( μ ^ + ∣ X ) + V ar ( μ ^ − ∣ X ) = nh R ∗ ( k ∗ ) ( f ( c + ) σ 2 ( c + ) + f ( c − ) σ 2 ( c − ) ) + o p ( nh 1 ) ≡ V ( h ) 【数理的結論】 :
分母に現れる n h nh nh
カットオフ付近のデータ密度 f ( c ) f(c) f ( c ) σ 2 ( c ) \sigma^2(c) σ 2 ( c )
バンド幅選択のジレンマ:MSE最小化と漸近推測の破綻
カーネル法による局所線形推定を行う際、実証分析者が直面する最大の意思決定が「バンド幅 h h h です。
文献(p.66)では、このバンド幅選択基準について次のように言及されています:
「今の場合、スコアのサポート全体で回帰関数の良い推定量を得る必要はないので、MISE ではなく、τ ^ r d d \hat{\tau}_{\mathrm{rdd}} τ ^ rdd
ここで登場する MISE と MSE の違いは、ノンパラメトリック回帰全般と RDD との「分析目的の決定的な違い」を象徴しています。
【徹底比較】MISE(平均積分二乗誤差)と MSE(平均二乗誤差)の違い
比較項目 MSE(平均二乗誤差) MISE(平均積分二乗誤差) 数式的定義 M S E ( τ ^ ) ≡ E [ ( τ ^ − τ ) 2 ] \mathrm{MSE}(\hat{\tau}) \equiv \mathbb{E}[(\hat{\tau} - \tau)^2] MSE ( τ ^ ) ≡ E [( τ ^ − τ ) 2 ] M I S E ( m ^ ) ≡ E [ ∫ X ( m ^ ( x ) − m ( x ) ) 2 w ( x ) d x ] \mathrm{MISE}(\hat{m}) \equiv \mathbb{E}\left[ \int_{\mathcal{X}} (\hat{m}(x) - m(x))^2 w(x) \, dx \right] MISE ( m ^ ) ≡ E [ ∫ X ( m ^ ( x ) − m ( x ) ) 2 w ( x ) d x ] 評価の対象 「特定の1点(または1つのスカラー)」 の局所的精度「定義域(サポート)全体の曲線・関数全体」 の全体的精度積分の有無 なし(Pointwise: 局所的な1点評価) あり(Integrated: サポート X \mathcal{X} X 主な用途 回帰不連続デザイン(RDD) の処置効果推定通常のノンパラメトリック回帰・カーネル密度推定 最適バンド幅の狙い カットオフ c c c 全区間で平均的にカーブが綺麗に再現されるよう調整
1. 通常のノンパラメトリック回帰の目的:関数全体を復元する「MISE」
通常のノンパラメトリック回帰やカーネル密度推定(本書の3.1節〜3.2節)では、スコア X X X X \mathcal{X} X m ( x ) = E [ Y ∣ X = x ] m(x) = \mathbb{E}[Y \mid X=x] m ( x ) = E [ Y ∣ X = x ] 「曲線全体の形状」 を滑らかに復元することがゴールです。
そのため、定義域のすべての点 x x x 平均積分二乗誤差(MISE: Mean Integrated Squared Error) を最小化するようにバンド幅を選びます(クロスバリデーションやSilvermanの公式など)。
2. RDD の目的:境界線上の1点だけを射抜く「MSE」
しかし、RDD(回帰不連続デザイン)において私たちが興味を持っているのは何でしょうか?
「0点付近で回帰曲線がどう曲がっているか」や「100点満点付近での傾きがどうなっているか」には、一切興味がありません 。
唯一の関心事は、合格境界線 c c c 「カットオフ直上における段差 τ r d d = μ + − μ − \tau_{\mathrm{rdd}} = \mu_+ - \mu_- τ rdd = μ + − μ − です。
スコア全体で綺麗な関数をフィットさせる必要は全くないため、全域を積分する MISE ではなく、カットオフ c c c τ ^ r d d \hat{\tau}_{\mathrm{rdd}} τ ^ rdd を局所的に最小化するバンド幅を選ぶのが最も理にかなっているのです。
漸近平均二乗誤差(AMSE)の定式化とトレードオフ
推定量 τ ^ r d d \hat{\tau}_{\mathrm{rdd}} τ ^ rdd 「バイアスの自乗」 と「分散」 の和として次のように分解されます。
M S E ( τ ^ r d d ) ≡ E [ ( τ ^ r d d − τ r d d ) 2 ∣ X ] = B ( h ) 2 ⏟ バイアスの自乗 + V ( h ) ⏟ 分散 \mathrm{MSE}(\hat{\tau}_{\mathrm{rdd}}) \equiv \mathbb{E}[(\hat{\tau}_{\mathrm{rdd}} - \tau_{\mathrm{rdd}})^2 \mid \mathbf{X}] = \underbrace{B(h)^2}_{\text{バイアスの自乗}} + \underbrace{V(h)}_{\text{分散}} MSE ( τ ^ rdd ) ≡ E [( τ ^ rdd − τ rdd ) 2 ∣ X ] = バイアスの自乗 B ( h ) 2 + 分散 V ( h ) ここに、先ほど求めた漸近バイアス B ( h ) ∝ h 2 B(h) \propto h^2 B ( h ) ∝ h 2 V ( h ) ∝ 1 n h V(h) \propto \frac{1}{nh} V ( h ) ∝ nh 1
バイアスの自乗: B ( h ) 2 ∝ ( h 2 ) 2 = h 4 B(h)^2 \propto (h^2)^2 = h^4 B ( h ) 2 ∝ ( h 2 ) 2 = h 4 C 1 C_1 C 1
分散: V ( h ) ∝ 1 n h V(h) \propto \frac{1}{nh} V ( h ) ∝ nh 1 C 2 C_2 C 2
すると、漸近的な平均二乗誤差(Asymptotic MSE, AMSE)は、バンド幅 h h h
A M S E ( h ) = C 1 h 4 + C 2 n h \mathrm{AMSE}(h) = C_1 h^4 + \frac{C_2}{nh} AMSE ( h ) = C 1 h 4 + nh C 2 ここには、実証分析者が必ず直面する「バイアスと分散のトレードオフ(二律背反)」 が明確に表れています:
バンド幅 h h h :遠くのデータまで含めてしまうため、直線近似の誤差が膨らみ、バイアス C 1 h 4 C_1 h^4 C 1 h 4 バンド幅 h h h :窓の中のデータ数が激減するため、推定値が激しくばらつき、分散 C 2 n h \frac{C_2}{nh} nh C 2
最適バンド幅 h M S E ∝ n − 1 / 5 h_{\mathrm{MSE}} \propto n^{-1/5} h MSE ∝ n − 1/5
では、このトレードオフのバランスが最も良くなり、誤差 A M S E ( h ) \mathrm{AMSE}(h) AMSE ( h ) h h h 「微分してイコールゼロと置く(極小値の条件)」 だけで簡単に計算できます。行間を一行ずつ埋めてみましょう。
h h h 1 h = h − 1 \frac{1}{h} = h^{-1} h 1 = h − 1
d d h A M S E ( h ) = d d h ( C 1 h 4 + C 2 n h − 1 ) = 4 C 1 h 3 − C 2 n h − 2 = 4 C 1 h 3 − C 2 n h 2 \frac{d}{dh} \mathrm{AMSE}(h) = \frac{d}{dh} \left( C_1 h^4 + \frac{C_2}{n} h^{-1} \right) = 4 C_1 h^3 - \frac{C_2}{n} h^{-2} = 4 C_1 h^3 - \frac{C_2}{n h^2} d h d AMSE ( h ) = d h d ( C 1 h 4 + n C 2 h − 1 ) = 4 C 1 h 3 − n C 2 h − 2 = 4 C 1 h 3 − n h 2 C 2
微分をゼロと置く(一階条件) :
4 C 1 h 3 − C 2 n h 2 = 0 ⟹ 4 C 1 h 3 = C 2 n h 2 4 C_1 h^3 - \frac{C_2}{n h^2} = 0 \implies 4 C_1 h^3 = \frac{C_2}{n h^2} 4 C 1 h 3 − n h 2 C 2 = 0 ⟹ 4 C 1 h 3 = n h 2 C 2
両辺に h 2 h^2 h 2 h h h :
4 C 1 h 5 = C 2 n ⟹ h 5 = C 2 4 C 1 ⋅ 1 n 4 C_1 h^5 = \frac{C_2}{n} \implies h^5 = \frac{C_2}{4 C_1} \cdot \frac{1}{n} 4 C 1 h 5 = n C 2 ⟹ h 5 = 4 C 1 C 2 ⋅ n 1
両辺の 5 5 5 1 / 5 1/5 1/5 :
h M S E = ( C 2 4 C 1 ) 1 / 5 n − 1 / 5 ∝ n − 1 / 5 h_{\mathrm{MSE}} = \left( \frac{C_2}{4 C_1} \right)^{1/5} n^{-1/5} \propto n^{-1/5} h MSE = ( 4 C 1 C 2 ) 1/5 n − 1/5 ∝ n − 1/5
なんと、「サンプルサイズ n n n − 1 / 5 -1/5 − 1/5 h h h であることが数学的に一意に導かれました。
Imbens and Kalyanaraman (2012, IK) などはこの公式に基づき、データから最適なバンド幅を自動計算するアルゴリズムを提案しました。
なぜ点推定で「最適」なバンド幅を使うと、信頼区間が「崩壊」するのか?
点推定の精度(二乗誤差の最小化)という観点では、上記の h M S E ∝ n − 1 / 5 h_{\mathrm{MSE}} \propto n^{-1/5} h MSE ∝ n − 1/5 統計的推測における深刻な罠(パラドックス) が潜んでいます。
実証研究の目的は、単に点推定値を出すだけでなく、「効果の 95% 信頼区間を求め、p p p H 0 : τ = 0 H_0: \tau = 0 H 0 : τ = 0 ことです。
推定量を中心化し、標準誤差 V ( h ) \sqrt{V(h)} V ( h ) Z Z Z
τ ^ r d d − τ r d d V ( h ) = τ ^ r d d − E [ τ ^ r d d ∣ X ] V ( h ) ⏟ (A) 偶然のばらつき(正規分布) + B ( h ) V ( h ) ⏟ (B) 標準化バイアス(系統的ズレ) \frac{\hat{\tau}_{\mathrm{rdd}} - \tau_{\mathrm{rdd}}}{\sqrt{V(h)}} = \underbrace{\frac{\hat{\tau}_{\mathrm{rdd}} - \mathbb{E}[\hat{\tau}_{\mathrm{rdd}} \mid \mathbf{X}]}{\sqrt{V(h)}}}_{\text{(A) 偶然のばらつき(正規分布)}} + \underbrace{\frac{B(h)}{\sqrt{V(h)}}}_{\text{(B) 標準化バイアス(系統的ズレ)}} V ( h ) τ ^ rdd − τ rdd = (A) 偶然のばらつき(正規分布) V ( h ) τ ^ rdd − E [ τ ^ rdd ∣ X ] + (B) 標準化バイアス(系統的ズレ) V ( h ) B ( h )
(A) の項 :平均を引いて標準誤差で割っているので、中心極限定理により平均 0 0 0 1 1 1 N ( 0 , 1 ) \mathcal{N}(0, 1) N ( 0 , 1 ) 問題は (B) の項(標準化バイアス) です:
分子のバイアス B ( h ) B(h) B ( h ) V ( h ) \sqrt{V(h)} V ( h ) h ∝ n − 1 / 5 h \propto n^{-1/5} h ∝ n − 1/5
分子のバイアス: B ( h ) = O ( h 2 ) = O ( ( n − 1 / 5 ) 2 ) = O ( n − 2 / 5 ) \text{分子のバイアス: } B(h) = O(h^2) = O\left( (n^{-1/5})^2 \right) = O(n^{-2/5}) 分子のバイアス : B ( h ) = O ( h 2 ) = O ( ( n − 1/5 ) 2 ) = O ( n − 2/5 ) 分母の標準誤差: V ( h ) = O ( 1 n h ) = O ( 1 n ⋅ n − 1 / 5 ) = O ( n − 4 / 5 ) = O ( n − 2 / 5 ) \text{分母の標準誤差: } \sqrt{V(h)} = O\left( \sqrt{\frac{1}{nh}} \right) = O\left( \sqrt{\frac{1}{n \cdot n^{-1/5}}} \right) = O\left( \sqrt{n^{-4/5}} \right) = O(n^{-2/5}) 分母の標準誤差 : V ( h ) = O ( nh 1 ) = O ( n ⋅ n − 1/5 1 ) = O ( n − 4/5 ) = O ( n − 2/5 ) 驚くべきことに、「分子のバイアス」と「分母の標準誤差」の収束スピードが、まったく同じ O ( n − 2 / 5 ) O(n^{-2/5}) O ( n − 2/5 )
分子も分母も同じ速さで縮むため、割り算をすると n n n n n n 10 10 10 100 100 100
lim n → ∞ B ( h ) V ( h ) = γ ≠ 0 ( ゼロでない定数 ) \lim_{n \to \infty} \frac{B(h)}{\sqrt{V(h)}} = \gamma \neq 0 \quad (\text{ゼロでない定数}) n → ∞ lim V ( h ) B ( h ) = γ = 0 ( ゼロでない定数 ) 信頼区間の「過小被覆(Undercoverage)」の悲劇
その結果、標準化統計量は平均 0 0 0 平均が γ \gamma γ に漸近してしまいます:
τ ^ r d d − τ r d d V ( h ) → d N ( γ , 1 ) \frac{\hat{\tau}_{\mathrm{rdd}} - \tau_{\mathrm{rdd}}}{\sqrt{V(h)}} \xrightarrow{d} \mathcal{N}(\gamma, 1) V ( h ) τ ^ rdd − τ rdd d N ( γ , 1 ) このズレ γ \gamma γ 0 0 0 95 % 95\% 95% τ ^ r d d ± 1.96 V ( h ) \hat{\tau}_{\mathrm{rdd}} \pm 1.96 \sqrt{V(h)} τ ^ rdd ± 1.96 V ( h ) 「95%の確率で真値を含むはずの信頼区間が、実際には 70% や 80% 程度しか真値を含まない」 という深刻な過小被覆(Undercoverage) を引き起こします。これが「推測の破綻」の正体です。
古典的な苦肉の策は、あえてMSE最適レートよりもバンド幅を小さく取る過小平滑化(Undersmoothing: h = o ( n − 1 / 5 ) h = o(n^{-1/5}) h = o ( n − 1/5 ) でした。しかし、これには「具体的にどれくらい小さくすればいいのか」という客観的な基準がなく、分析者の恣意性が残る欠点がありました。
Calonico-Cattaneo-Titiunik (CCT) の頑健バイアス修正
この推測の危機を鮮やかに解決したのが、Calonico, Cattaneo, and Titiunik (2014, CCT) です。文献 p.67 に示される通り、CCTはバイアスを過小平滑化で押し殺すのではなく、バイアス項 B ( h ) B(h) B ( h )
τ ^ r d d b c = τ ^ r d d − B ^ ( h , b ) \hat{\tau}_{\mathrm{rdd}}^{\mathrm{bc}} = \hat{\tau}_{\mathrm{rdd}} - \hat{B}(h, b) τ ^ rdd bc = τ ^ rdd − B ^ ( h , b ) ここで b b b B ^ ( h , b ) \hat{B}(h, b) B ^ ( h , b ) B ^ ( h , b ) \hat{B}(h, b) B ^ ( h , b )
CCTの真のブレークスルーは、推定量 τ ^ r d d \hat{\tau}_{\mathrm{rdd}} τ ^ rdd B ^ ( h , b ) \hat{B}(h, b) B ^ ( h , b ) τ ^ r d d b c \hat{\tau}_{\mathrm{rdd}}^{\mathrm{bc}} τ ^ rdd bc
V a r ( τ ^ r d d b c ∣ X ) = V ( h ) + W ( h , b ) \mathbb{V}\mathrm{ar}\left( \hat{\tau}_{\mathrm{rdd}}^{\mathrm{bc}} \mid \mathbf{X} \right) = V(h) + W(h, b) V ar ( τ ^ rdd bc ∣ X ) = V ( h ) + W ( h , b ) ここで W ( h , b ) W(h, b) W ( h , b ) V ^ b c ( h , b ) = V ^ ( h ) + W ^ ( h , b ) \hat{V}^{\mathrm{bc}}(h, b) = \hat{V}(h) + \hat{W}(h, b) V ^ bc ( h , b ) = V ^ ( h ) + W ^ ( h , b ) h ∝ n − 1 / 5 h \propto n^{-1/5} h ∝ n − 1/5
τ ^ r d d b c − τ r d d V ^ b c ( h , b ) → d N ( 0 , 1 ) \frac{\hat{\tau}_{\mathrm{rdd}}^{\mathrm{bc}} - \tau_{\mathrm{rdd}}}{\sqrt{\hat{V}^{\mathrm{bc}}(h, b)}} \xrightarrow{d} \mathcal{N}(0, 1) V ^ bc ( h , b ) τ ^ rdd bc − τ rdd d N ( 0 , 1 ) これにより、漸近的に 1 − α 1-\alpha 1 − α 頑健バイアス修正信頼区間(Robust Bias-Corrected Confidence Interval) が導出されます(文献 p.67 式(3.17))。
C I C C T = [ τ ^ r d d b c − z 1 − α / 2 V ^ b c ( h , b ) , τ ^ r d d b c + z 1 − α / 2 V ^ b c ( h , b ) ] (3.17) \mathrm{CI}_{\mathrm{CCT}} = \left[ \hat{\tau}_{\mathrm{rdd}}^{\mathrm{bc}} - z_{1-\alpha/2} \sqrt{\hat{V}^{\mathrm{bc}}(h, b)}, \quad \hat{\tau}_{\mathrm{rdd}}^{\mathrm{bc}} + z_{1-\alpha/2} \sqrt{\hat{V}^{\mathrm{bc}}(h, b)} \right] \tag{3.17} CI CCT = [ τ ^ rdd bc − z 1 − α /2 V ^ bc ( h , b ) , τ ^ rdd bc + z 1 − α /2 V ^ bc ( h , b ) ] ( 3.17 ) この理論体系は R/Stata パッケージ rdrobust に実装され、世界中の実証分析における標準デファクトとなりました。さらに Calonico, Cattaneo, and Farrell (2020) は、この頑健信頼区間の被覆誤差を最小化するバンド幅選択アルゴリズムを提案しています。
Kolesár and Rothe (2018) のオネスト(偽りのない)信頼区間
CCTのアプローチが世界を席巻する一方で、ノンパラメトリック推測理論の数理的フロンティアでは、より根本的な問題意識が提起されました。
CCTの頑健推測は「n → ∞ n \to \infty n → ∞ 1 − α 1-\alpha 1 − α
この問題に対し、Kolesár and Rothe (2018) は、真の回帰関数の滑らかさに事前の上限を課すことで、有限標本における「最悪のバイアス」を厳密に封じ込めるオネスト推測(Honest Inference) を提案しました(文献 p.68-69)。
文献 p.68 に従い、一様カーネル k ( u ) = 1 2 1 ( ∣ u ∣ ≤ 1 ) k(u) = \frac{1}{2}\mathbf{1}(|u| \le 1) k ( u ) = 2 1 1 ( ∣ u ∣ ≤ 1 ) τ ˇ h \check{\tau}_h τ ˇ h
min α , τ h , β , γ ∑ i = 1 n 1 ( ∣ X i − c ∣ ≤ h ) ( Y i − α − τ h D i − β ( X i − c ) − γ D i ( X i − c ) ) 2 \min_{\alpha, \tau_h, \beta, \gamma} \sum_{i=1}^n \mathbf{1}(|X_i - c| \le h) \left( Y_i - \alpha - \tau_h D_i - \beta (X_i - c) - \gamma D_i (X_i - c) \right)^2 α , τ h , β , γ min i = 1 ∑ n 1 ( ∣ X i − c ∣ ≤ h ) ( Y i − α − τ h D i − β ( X i − c ) − γ D i ( X i − c ) ) 2 近傍の標本サイズを n h = ∑ i = 1 n 1 ( ∣ X i − c ∣ ≤ h ) n_h = \sum_{i=1}^n \mathbf{1}(|X_i - c| \le h) n h = ∑ i = 1 n 1 ( ∣ X i − c ∣ ≤ h ) τ ˉ h = E [ τ ˇ h ∣ X ] \bar{\tau}_h = \mathbb{E}[\check{\tau}_h \mid \mathbf{X}] τ ˉ h = E [ τ ˇ h ∣ X ] σ ^ \hat{\sigma} σ ^
n h ( τ ˇ h − τ r d d ) σ ^ = n h ( τ ˇ h − τ ˉ h ) σ ^ ⏟ サンプリング誤差(確率項) + n h ( τ ˉ h − τ r d d ) σ ^ ⏟ 有限標本バイアス(確定項) \frac{\sqrt{n_h} (\check{\tau}_h - \tau_{\mathrm{rdd}})}{\hat{\sigma}} = \underbrace{\frac{\sqrt{n_h} (\check{\tau}_h - \bar{\tau}_h)}{\hat{\sigma}}}_{\text{サンプリング誤差(確率項)}} + \underbrace{\frac{\sqrt{n_h} (\bar{\tau}_h - \tau_{\mathrm{rdd}})}{\hat{\sigma}}}_{\text{有限標本バイアス(確定項)}} σ ^ n h ( τ ˇ h − τ rdd ) = サンプリング誤差(確率項) σ ^ n h ( τ ˇ h − τ ˉ h ) + 有限標本バイアス(確定項) σ ^ n h ( τ ˉ h − τ rdd ) サンプリング誤差項は、バンド幅 h h h N ( 0 , 1 ) \mathcal{N}(0, 1) N ( 0 , 1 ) μ ( x ) = E [ Y i ∣ X i = x ] \mu(x) = \mathbb{E}[Y_i \mid X_i = x] μ ( x ) = E [ Y i ∣ X i = x ] M \mathcal{M} M
M = { μ : ∣ μ ′ ( a ) − μ ′ ( b ) ∣ ≤ K ∣ a − b ∣ for all a , b < c and all a , b > c } (3.18) \mathcal{M} = \left\{ \mu : |\mu'(a) - \mu'(b)| \le K |a - b| \quad \text{for all } a, b < c \text{ and all } a, b > c \right\} \tag{3.18} M = { μ : ∣ μ ′ ( a ) − μ ′ ( b ) ∣ ≤ K ∣ a − b ∣ for all a , b < c and all a , b > c } ( 3.18 ) 定数 K K K M \mathcal{M} M 最悪のバイアスの上限(Worst-case Bias) を探索します。
r ˉ s u p ≡ sup μ ∈ M n h ∣ τ ˉ h − τ r d d ∣ σ ^ \bar{r}_{\mathrm{sup}} \equiv \sup_{\mu \in \mathcal{M}} \frac{\sqrt{n_h} |\bar{\tau}_h - \tau_{\mathrm{rdd}}|}{\hat{\sigma}} r ˉ sup ≡ μ ∈ M sup σ ^ n h ∣ τ ˉ h − τ rdd ∣ バイアスの絶対値が最大でも r ˉ s u p \bar{r}_{\mathrm{sup}} r ˉ sup r ˉ s u p \bar{r}_{\mathrm{sup}} r ˉ sup ∣ N ( r ˉ s u p , 1 ) ∣ |\mathcal{N}(\bar{r}_{\mathrm{sup}}, 1)| ∣ N ( r ˉ sup , 1 ) ∣ z 1 − α / 2 z_{1-\alpha/2} z 1 − α /2 c v 1 − α ( r ˉ s u p ) cv_{1-\alpha}(\bar{r}_{\mathrm{sup}}) c v 1 − α ( r ˉ sup )
これによって構築されるのがオネスト信頼区間(Honest Confidence Interval) です(文献 p.69)。
C I h o n e s t = [ τ ˇ h − c v 1 − α ( r ˉ s u p ) σ ^ n h , τ ˇ h + c v 1 − α ( r ˉ s u p ) σ ^ n h ] \mathrm{CI}_{\mathrm{honest}} = \left[ \check{\tau}_h - cv_{1-\alpha}(\bar{r}_{\mathrm{sup}}) \frac{\hat{\sigma}}{\sqrt{n_h}}, \quad \check{\tau}_h + cv_{1-\alpha}(\bar{r}_{\mathrm{sup}}) \frac{\hat{\sigma}}{\sqrt{n_h}} \right] CI honest = [ τ ˇ h − c v 1 − α ( r ˉ sup ) n h σ ^ , τ ˇ h + c v 1 − α ( r ˉ sup ) n h σ ^ ] この信頼区間は、文献 p.69 式(3.19) に示される漸近的一様妥当性(Asymptotic Uniform Validity) を達成します。
lim inf n → ∞ , μ ∈ M P μ ( τ r d d ∈ C I ) ≥ 1 − α (3.19) \liminf_{n \to \infty, \, \mu \in \mathcal{M}} P_\mu (\tau_{\mathrm{rdd}} \in \mathrm{CI}) \ge 1 - \alpha \tag{3.19} n → ∞ , μ ∈ M lim inf P μ ( τ rdd ∈ CI ) ≥ 1 − α ( 3.19 ) 【数式の記法について】
文献原本では、下極限記号 lim inf \liminf lim inf n → ∞ n \to \infty n → ∞ μ ∈ M \mu \in \mathcal{M} μ ∈ M 「有限標本 n n n μ ∈ M \mu \in \mathcal{M} μ ∈ M inf μ ∈ M P μ \inf_{\mu \in \mathcal{M}} P_\mu inf μ ∈ M P μ を取った上で、サンプルサイズ n → ∞ n \to \infty n → ∞
lim inf n → ∞ [ inf μ ∈ M P μ ( τ r d d ∈ C I ) ] ≥ 1 − α \liminf_{n \to \infty} \left[ \inf_{\mu \in \mathcal{M}} P_\mu (\tau_{\mathrm{rdd}} \in \mathrm{CI}) \right] \ge 1 - \alpha n → ∞ lim inf [ μ ∈ M inf P μ ( τ rdd ∈ CI ) ] ≥ 1 − α を1つにまとめたものと同値です。
どのような悪意あるデータ生成過程(μ ∈ M \mu \in \mathcal{M} μ ∈ M 1 − α 1-\alpha 1 − α
で、私(筆者)はどう考えるか?
最先端の数理的到達点を踏まえた上で、実証研究者・データサイエンティストの立場から、実務のリアルな課題と私の見解を述べます。
1. CCT頑健推測とオネスト信頼区間の「哲学的断絶」
実証分析の現場において、CCT(rdrobust)と Kolesár-Rothe(オネスト信頼区間)のどちらを採用すべきかという議論は、単なるツールの優劣ではなく、「分析者がデータ生成過程(DGP)に対してどのような認識論的立場を取るか」 という思想の対立を浮き彫りにします。
CCT(データ適応・実用主義アプローチ) :
「サンプルサイズが十分にあれば、局所的な曲率もデータ自身から推定可能である」という立場です。バイアスの推定分散を正しく織り込むことで、通常のデータ環境下で過度に信頼区間を広げることなく、高い検出力(Power)を維持します。Kolesár-Rothe(ワーストケース保証・保守主義アプローチ) :
「曲率の推定値そのものが有限標本誤差を孕む以上、漸近理論に頼った点修正は過小被覆のリスクを排除できない」という数理的厳密主義です。
私は、探索的データ分析や一般的なビジネス分析においては CCT(rdrobust)を標準推定量として採用しつつ、制度設計に関わる政策評価やトップジャーナル向けの研究論文においては、Kolesár-Rothe のオネスト推測を用いた「感度分析(Sensitivity Analysis)」を必ず併記すべき だと考えます。
なぜなら、文献 p.70 でも鋭く指摘されている通り、Kolesár-Rothe アプローチの唯一かつ最大のアキレス腱は、「曲率の上限パラメータ K K K という点にあるからです。もし K K K
したがって、実証現場における最も知的誠実なアプローチは、「K K K K K K
2. 他の準実験手法(DID・IV)との比較とRDDの特異性
因果推論の主要な武器である差の差法(DID)は「平行トレンド仮定」、操作変数法(IV)は「除外制約(Exclusion Restriction)」という、データそのものからは本質的に検証不可能な反実仮想の仮定に依存しています。これらは往々にして、査読者やステークホルダーとの間で水掛け論の議論に陥りがちです。
対照的に、RDDが要求する「カットオフにおける連続性仮定」は、以下の偽証テスト(Falsification Tests) を通じて、データから直接的かつ客観的に防護壁を築くことができます。
マクラリー密度検定(McCrary Density Test) :
カットオフ境界 c c c X X X f ( X ) f(X) f ( X ) 所与の共変量のバランス検定 :
年齢、性別、事前学力、過去の所得など、処置の影響を受けるはずのない事前属性がカットオフ境界で連続的に推移しているかを検証します。プラセボ・カットオフ検定 :
制度的な処置の割り当てが一切存在しない偽の閾値(例えば c / 2 c/2 c /2 1.5 c 1.5c 1.5 c
このように、仮定の妥当性をグラフィカルかつ統計的検定によって白日の下に晒せる透明性の高さこそが、RDDが準実験デザインの「ゴールドスタンダード」と呼ばれる最大の理由です。
3. スコアが離散値である場合の深刻な落とし穴
実務のデータ分析において極めて高頻度で遭遇するにもかかわらず、多くの実務家が見落としているのが「スコア変数が離散的(Discrete Running Variable)である問題」 です。
入試の得点(1点刻み)、信用スコア、勤続年数、年齢(月単位・年単位)など、現実の制度変数には離散値が溢れています。スコアが離散的である場合、カットオフ c c c h → 0 h \to 0 h → 0
この状況で安易に連続変数用の CCT 推測(rdrobust)を適用すると、カットオフ直近の離散セル内の分散構造を誤認し、標準誤差を過小推定して偽陽性(誤った有意判定)を導く危険があります。スコア変数が離散的である環境下では、近傍の個体が完全に無作為に振り分けられているとみなす局所無作為化アプローチ(Local Randomization Approach) を採用するか、まさに Kolesár and Rothe (2018) が提示した「離散スコアに対応したオネスト信頼区間」へ切り替えるのが、数理的に正しい処方箋です。
まとめ & 実務指針チェックリスト
回帰不連続デザイン(RDD)は、カットオフにおける極限値の段差として因果効果を厳密に識別します。しかし、実標本からその段差を推定する作業は、境界バイアスと推測の歪みというノンパラメトリック統計特有の難問との格闘です。
実務家および研究者が心に刻むべきチェックリストを以下にまとめます。
安易な過小平滑化に頼らない :
バンド幅を縮小してバイアスを無視する旧来の手法は破棄し、バイアスの推定分散を正しく組み込んだ Calonico et al. (2014) の頑健バイアス修正(rdrobust)を標準推定量として採用する。オネスト信頼区間によるストレステスト :
回帰関数の曲率上限 K K K 離散スコアの罠を警戒する :
ランニング変数が離散値である場合は連続体漸近論に頼らず、局所無作為化アプローチや離散対応オネスト信頼区間へ適切に切り替える。3大偽証検定の完備 :
スコア密度の連続性検定(マクラリー検定)、事前共変量のバランス検定、プラセボ・カットオフ検定を必ず実施し、連続性仮定の正当性を多角的に証明する。
参考文献
Calonico, S., Cattaneo, M. D., & Titiunik, R. (2014). “Robust Nonparametric Confidence Intervals for Regression-Discontinuity Designs.” Econometrica , 82(6), 2295–2326.
Calonico, S., Cattaneo, M. D., & Farrell, M. H. (2020). “Optimal Bandwidth Selection for Robust Bias-Corrected Inference in Regression-Discontinuity Designs.” The Econometrics Journal , 23(2), 192–210.
Hahn, J., Todd, P., & van der Klaauw, W. (2001). “Identification and Estimation of Treatment Effects with a Regression-Discontinuity Design.” Econometrica , 69(1), 201–209.
Imbens, G., & Kalyanaraman, K. (2012). “Optimal Bandwidth Choice for the Regression Discontinuity Estimator.” The Review of Economic Studies , 79(3), 933–959.
Kolesár, M., & Rothe, C. (2018). “Inference in Regression Discontinuity Designs with a Discrete Running Variable.” American Economic Review , 108(8), 2277–2304.
🔗 あわせて読みたい当ブログの関連記事
📊 本日の自律型 AI ドキュメント解析レポート
解析対象 : データ駆動型回帰分析.pdf (p.73-79 (計 7 ページ / 全 192 ページ))判定ジャンル : statsJev 記事品質推敲(Evaluator-Optimizer) :
最終品質スコア: 8.89 / 12.0(判定: 足切り後採用)
モデル・因果関係の具体性: 2.50 / 3.0
構成の明快さ: 2.17 / 3.0
筆者オピニオン度: 2.72 / 3.0
知的好奇心刺激度: 1.50 / 3.0
「で、あなたの意見は?」リスク: 24.0%
自律推敲・改善プロセス (計 3 回): 第1稿: 7.85点 [要改善 (need_pedagogical_steps)] ➡️ 第2稿: 8.60点 [要改善 (need_pedagogical_steps)] ➡️ 第3稿: 8.89点 [要改善 (need_pedagogical_steps)]